本地大模型部署新进展研究报告:Qwen3.8-27B 与 DeepSeek-V4-Flash 的个人可用门槛、成本与十二个月推演
执行摘要
本地大模型部署在 2026 年首次对个人真正可行。Qwen3.8-27B(Apache 2.0、262K 原生上下文)与 DeepSeek-V4-Flash(284B 总参 / 13B 激活 MoE、1M 上下文、MIT 许可)构成"个人可部署双甜点":前者把旗舰级 Agent 能力压进 24GB 单卡,后者让 128GB 统一内存设备首次够得着前沿级模型[1][2][3][4]。可行性来自软件三红利的叠加兑现——投机解码出厂内置化(27B 单流提速 1.7-2.6×)、4-bit 量化近无损(Top-1 一致率 95.6%)、KV cache 逾百倍压缩(1M 上下文 KV 压至 2-7GB)[5][6][7]。
门槛结论:27B 甜点 = 24GB N 卡。Q4 权重约 17GiB,开启 MTP 后 RTX 3090/4090 实测 40-65 tok/s、32-64K 上下文舒适,整机约 2-3 万元;RTX 5090 可达 133-206 tok/s,但街价较 MSRP 溢价最高约 135%[8][9][10]。284B-MoE 甜点 = 128GB 统一内存(量化版 20-35 tok/s,整机 ¥1.4-3.4 万)或 4×48GB 多卡(10-13 万元级,DSpark 下最高 367 tok/s)[11][12][13]。其核心机理是 decode 速度 ≈ 内存带宽 ÷ 每 token 激活权重字节数:13B 激活使 20/40/60 tok/s 仅约需 150/300/450 GB/s——买硬件前先选架构,比加预算更决定性;中间的 70B 稠密档已被两极夹击而空洞化[14]。
回本结论:参照系决定一切。对照 DeepSeek 官方 API(重度 300M token/月账单仅约 ¥113),任何档位硬件永不回本;对照旗舰 API(Max 级)回本 8-13 个月,对照同模型百炼 API 约 36 个月,对照 Claude Max 20x 订阅(¥1,420/月)约 15 个月[15][16][17][18]。经济性成立的组合收敛为"重度 Agent 用户(≥300M token/月)+ 2 万元级硬件 + 高价参照系";隐私合规、离线可用、无 rate limit、可微调等隐性价值可让回本从第 0 天成立。
十二个月推演(基准情景,概率约 60%):模型更强更便宜——Qwen4 家族预计 2027 Q1 春节档落地、DeepSeek V5 预计 2027 Q2,旗舰激活比继续下探至 2-3%;硬件更贵——DRAM/GDDR 涨价预计持续至 2027 年达峰,NVIDIA 消费级空窗至 2027 H2,M5 Ultra(512GB / 1.2TB/s)在窗口内实质独占大内存甜点档;软件红利持续且自动落至存量硬件[19][20][21][22][23]。最大下行风险是授权收紧:"权重照发、授权收紧、顶配裁剪"成为常态的概率约 70%(推算),而权重下载后不受追溯——及时归档关键权重是零成本对冲[24][25]。
对决策者的压缩建议:需求已被现有模型覆盖者按需采购、不等硬件("等等党"逻辑在涨价周期内失效);唯一有明确时间锚的等待理由是 2027 Q1 的 Qwen4 甜点档;对数据敏感、依赖本地化的用户,当前"Apache 2.0 + MIT"的历史宽松窗口值得把握[26][27]。
1. 本地部署的新进展:模型、软件、硬件三线并进
截至 2026 年 8 月,本地大模型部署已从少数极客的炫技行为演变为开发者与中小企业的现实选择题:一端是开源权重的能力密度持续抬升——24GB 单卡可跑的模型在 Agent 类基准上开始反超一年前的 API 旗舰;另一端是推理软件栈在投机解码、低精度量化、KV cache 压缩三个方向同时兑现红利,而硬件侧却在 DRAM 超级周期下剧烈涨价。本章从模型、软件、硬件三条线综述当前格局,为后续章节展开具体部署门槛与成本测算建立坐标系。
1.1 模型侧:开源权重进入能力与可部署性的双重甜点期
1.1.1 Qwen3.8-27B 发布:28B 稠密多模态、262K 原生上下文、Apache 2.0,填补个人旗舰空缺
2026 年 8 月 3 日随 Qwen3.8-Max 宣布、8 月 14 日开放权重的 Qwen3.8-27B,是当前个人本地部署档位的代表性产品[1]。其精确参数量为 27,781,427,952,采用 64 层混合架构(48 层 Gated DeltaNet 线性注意力 + 16 层 GQA 全注意力),原生支持 262,144 token 上下文、可经 YaRN 扩展至 1M,且为原生视觉语言模型(图像与视频输入)[1][2]。权重以 BF16 safetensors 发布(55.6GB),许可证为 Apache 2.0——可商用、可修改、可再分发,且无营收与月活门槛[2]。
能力维度上,官方口径的 SWE-bench Pro 61.7、Terminal-Bench 2.1 73.0、OSWorld 84.3 使其在 agentic 工作流类任务上反超 Opus 4.6 Max,仅在知识与推理天花板类任务落后;发布后两周内即获 Harvey 法律 Agent 基准与 Arena.ai Image-to-WebDev 榜两个"开源权重第一"的第三方背书[28]。对部署者更关键的是:混合线性注意力架构使其 262K 上下文全开的 KV cache 仅约 16GiB(BF16),4-bit 量化权重约 17GB——24GB 显存首次能同时容纳"旗舰级能力 + 长上下文"[1][29]。
1.1.2 DeepSeek-V4-Flash 正式版:284B 总参/13B 激活 MoE、1M 上下文、MIT 许可,把前沿能力带上个人桌面
2026 年 7 月 31 日发布的 DeepSeek-V4-Flash-0731 正式版,是"前沿能力可本地化"的另一极。其架构为 284B 总参数 / 13B 激活的稀疏 MoE(43 层、256 路由专家 top-6 + 1 共享),HuggingFace 元数据实数 304.18B——差额来自直接打进 checkpoint 的 DSpark 投机解码草稿模块[3][30]。原生 1M 上下文经 YaRN factor 16 自 65,536 扩展而来,许可证为最宽松的 MIT[3][4]。
部署经济学上,V4-Flash 相对上代 V3/R1(671B 总参、FP8 权重约 642GB、常规需 8 卡 H100 起步、整机 120 万元级)实现了约 4-5 倍的门槛下降:官方 QAT 原生 MXFP4 混合精度权重实测仅 155.4 GiB,2×H200 或 3-4 张工作站卡即可全精度运行;经社区动态量化压缩至 82.5-104GB 后,128GB 统一内存设备首次可以运行前沿级模型[4][11][31][32]。需要注意的认知边界是"13B 激活 ≠ 13B 显存"——显存需求由总参数决定,全部专家权重必须常驻[31]。
1.1.3 格局分层固化:万亿级 API-only,与可本地部署档位拉开距离
与个人甜点档扩容形成对照的是顶部的彻底脱离:Kimi K3(2.8T 总参、896 专家)虽以修改版 MIT 开放权重,但部署需 ≥1.5TB 显存、官方建议 64 卡超节点,硬件成本千万级——"开源权重"与"个人可部署"首次彻底解耦[33];Qwen3.8-Max(2.4T-A95B)虽为首个开放权重的 Max 级模型,却附带自定义商业许可并裁剪视觉模态,实质仍是 API 主导[25]。中间层则出现"名义开源、实际不可部署"的灰色带,GLM-5.2(744B/40B 激活,MIT)已逼近机构部署上限[34]。
由此,可本地部署的能力上限稳定在两个档位:≤35B 稠密档与 100-400B 高稀疏 MoE 档。商业逻辑支撑着这两个档位的持续供给——OpenRouter 上开源模型 token 份额已从 2026 年 1 月的 34% 升至 6 月的 65%,"不开源 = 出局"的份额压力使厂商难以放弃中小尺寸开放权重[27]。
表 1-1 2026 年代表性可本地部署开放权重模型一览
| 模型 | 发布时间 | 总参/激活 | 架构 | 原生上下文 | 许可证 | 个人部署门槛 |
|---|---|---|---|---|---|---|
| Qwen3.8-27B | 2026-08 | 27.8B(稠密) | 混合线性注意力 VLM | 262K(YaRN 至 1M) | Apache 2.0 | 24GB 单卡(4-bit ~17GB)[1] |
| DeepSeek-V4-Flash-0731 | 2026-07 | 284B/13B(MoE) | CSA+HCA 混合注意力 | 1M | MIT | 全精度 ≥192GB;量化后 128GB 统一内存[4][11] |
| Qwen3.8-Flash-Next | 2026-08 | 125B/6B(+51B n-gram 表) | GDN+QSA(Qwen4 预览) | 262K | Qwen Community License 1.0 | FP8 约 168GB,逼近 192GB 工作站档[19] |
| GLM-5.2 | 2026-06 | 744B/40B(MoE) | DeepSeek V3.x 底座衍生 | 202K 级 | MIT | 机构级(8 卡 H100 档),超个人范畴[34] |
| Gemma 4 31B Dense | 2026-04 | 31B(稠密) | 纯稠密 | 256K | Apache 2.0 | 24GB 单卡可跑,编码弱于同档 Qwen[35] |
上表揭示两个结构性事实。其一,个人部署的"甜点双极"已经成形:27B 稠密 + 24GB 单卡、300B 级高稀疏 MoE + 128-256GB 统一内存,中间的 70B 稠密档因"既要 48GB+ 显存又吃带宽"被两极夹击而空洞化。其二,激活参数占比成为新的竞争指标——从 V3 的 5.5% 降至 V4-Flash 的 4.6%、Flash-Next 的 4.8%(计入 n-gram 表仅 3.3%),厂商在以"每 token 实际读取的参数量"换取消费级带宽下的可用速度,这一趋势直接决定了下一节软件红利的发挥空间[19]。
1.2 软件侧:推理栈三大红利持续降低门槛
1.2.1 投机解码出厂内置化:llama.cpp 合并 MTP 带来 1.7-2.6×,DeepSeek 将 DSpark 草稿模块打进 checkpoint
投机解码(speculative decoding,用小草稿模型/草稿头预测、大模型并行验证,输出分布严格等价)在 2026 年完成了从"用户侧外挂技巧"到"厂商发布物一部分"的转变。2026 年 5 月 16 日 llama.cpp 合并 MTP 支持(PR #22673)后,内置 MTP 头的 Qwen3.x-27B 单流实测提速 1.7-2.6×:RTX 3090 从 38.9 升至 65 tok/s、DGX Spark 从 7.0 升至 18.0 tok/s、RTX 5090 达约 140 tok/s[5][36]。DeepSeek 更进一步,把 DSpark 草稿模块直接封装进 V4-Flash 的 0731 checkpoint,官方自报在已有 MTP-1 加速之上单用户再提速 60-85%、总吞吐 +51%;vLLM 0.25 与 llama.cpp(PR #25784,约 1.9×)均已落地,8×H20 生产实测单并发 600+ TPS[30][37][38]。Apple 生态同步补课:mlx-lm 0.21 使 M5 Max 上 70B 模型从 45 升至 95+ tok/s(约 2.1×)[39]。其含义是:评估新模型的本地速度时,账面带宽需求可因自带投机解码打 5-6 折——这等于免费升级一代硬件。
1.2.2 低精度全栈落地:FP4(NVFP4/MXFP4)与 2-bit 动态量化使超大模型体积减半再减半
2026 年 4-bit 已是"无损感"默认线:Qwen3.8-27B 的 Q4_K_M(17.1GB)与 BF16 的 Top-1 一致率仍达 95.6%,Q4→Q2 才出现质量断崖[6]。硬件原生 FP4 进入推理栈:消费级 Blackwell 实测 NVFP4 较 BF16 吞吐 +1.6×、能耗 -41%、质量损失仅 2-4%[40];DeepSeek-V4-Flash 则把范式推进到"官方权重即量化权重"——96% 的专家参数以 QAT 原生 MXFP4 存储,Unsloth 可逐位无损重打包(KLD≈0),动态 2-3 bit 档进一步把 284B 模型压至 82.5-104GB,代价是 KLD 升至 0.24-0.36、质量"能用而非好用"[11]。FP4 对个人用户最大的价值不是更快,而是"原本装不下的模型现在装得下"。
1.2.3 KV cache 压缩革命:1M 上下文 KV 占用从数百 GB 压至个位数 GB,长上下文瓶颈回到权重本身
长上下文的显存账在 2026 年被改写:传统 GQA 稠密模型 1M 上下文的 KV cache 约 300GB 量级,DeepSeek MLA 降至 65-84GB,而 V4 代的 CSA(4 倍压缩)+ HCA(128 倍压缩)+ K=V 共享把 1M KV 压至 4-7GB,叠加 KV 量化后仅 2-3GB——逾百倍的压缩中架构创新贡献约 100×、KV 量化贡献 2-4×[7][41]。推理引擎层的通用 KV 量化同样可观:q4_0 KV 使 256K 上下文的 KV 显存从 8.2GB 降至 2.3GB(-71%)且质量损失可忽略[42]。Qwen3.8-27B 则靠 48/64 层线性注意力使 262K 全开仅需 16GiB(FP8 KV 减半至 8GiB)[29]。结论是长上下文已不再是独立瓶颈,本地 1M 的第一道门槛回到权重体积本身——128GB 设备上 64-128K 是甜区,1M 仍需 200GB+ 内存级硬件[4]。
表 1-2 推理栈三大软件红利收益对照(2025-09 ~ 2026-08)
| 红利 | 标志性进展 | 实测收益 | 硬件含义 |
|---|---|---|---|
| 投机解码内置化 | llama.cpp PR #22673;DSpark 入 checkpoint;LM Studio 0.4.14 转稳定版 | 27B 稠密单流 1.7-2.6×;DSpark 在 MTP 之上再 +60-85%(官方自报) | 账面带宽需求打 5-6 折[5][37] |
| 低精度全栈落地 | QAT 原生 MXFP4;NVFP4 进 vLLM/SGLang/llama.cpp;动态 2-3 bit | 4-bit 近无损(Top-1 95.6%);284B 压至 82.5GB(约 53%) | 显存/内存门槛下降约 2-4 倍[11][6] |
| KV cache 压缩 | CSA/HCA 架构级压缩 + FP8/Q4 KV 量化 | 1M 上下文 KV 从 ~300GB 压至 2-7GB;256K KV -71% | 长上下文瓶颈从 KV 回归权重[7][42] |
三项红利的叠加效应是非线性的:量化决定"装不装得下",KV 压缩决定"上下文能开多长",投机解码决定"跑起来有多快"。但三者都存在适用边界——MTP 红利集中于稠密模型(MoE 上仅约 1.17×),2-bit 量化仅对 ≥100B 的高冗余 MoE 成立,KV 低 bit 量化在 32K 以上长上下文会累积检索误差[36][42]。这解释了为何 2026 年的模型发布普遍把三项技术当作"出厂配置"协同设计,而非留给用户自行组装。
1.3 硬件侧:带宽竞赛与内存涨价危机并存
1.3.1 三条硬件路线成形:N 卡独显 / Apple 统一内存 / AMD Strix Halo 与 DGX Spark 大内存小主机
硬件竞赛的计价货币已从 TOPS 切换为"内存带宽 × 容量"。第一条路线是 NVIDIA 独显:RTX 5090 以 1,792GB/s 带宽与 FP4 支持成为 27B 档性能上限(开 MTP 后 133-206 tok/s),但消费卡无 NVLink 限制了多卡扩展[36][10]。第二条是 Apple 统一内存:2026 年 8 月 25 日发布的 M5 Ultra Mac Studio 提供最高 512GB 统一内存与 1.2TB/s 带宽(国行 ¥46,999 起,9 月 22 日发货),按带宽推算可在单机以 55-75 tok/s 运行 V4-Flash 量化档,是目前唯一"开箱即用"的单机 300B 级方案[21]。第三条是大内存小主机:AMD Strix Halo(256GB/s)与 NVIDIA DGX Spark(约 273GB/s)带宽不足以流畅跑稠密 27B(仅 10-13 tok/s),但对低激活 MoE 友好,且 128GB 容量配合量化可承担 V4-Flash 的"可用级"运行[43]。
1.3.2 GDDR7 与 DRAM 涨价:RTX 5090 从 4,100+ 街价,采购逻辑被改写
与软件红利方向相反,硬件成本在 2026 年剧烈恶化。AI 服务器对 HBM 产能的虹吸使三大原厂缩减消费级 DRAM/GDDR 投片,2026 Q1 主流 DRAM 合约价同比 +92%;TrendForce 口径下 3GB GDDR7 颗粒涨至 320、或占整卡成本 30-40%[44][26]。终端价格随之失控:RTX 5090 美国街价达 1,999 MSRP 溢价约 135%-145%),国内全新非公成交价 27,500-35,000 元;RTX PRO 6000 96GB 官方价一年半内从 $8,565 涨至 $16,000[10][26][45]。涨价沿整机传导——16GB DDR5 单条从 450 元涨至 1,800 元(+300%),Strix Halo 整机从 $1,999 涨至 $3,449 且缺货,DGX Spark 亦提价约 18%[43][26]。供应侧 RTX 50 SUPER 系列被无限期搁置,行情预判涨价持续至 2027 年达峰、2028 年才趋稳[26]。
对采购逻辑的含义是直接的:模型权重免费、API 极便宜、软件红利免费兑现,唯独硬件在变贵——"等等党"逻辑在 2026-2027 年窗口内失效,等待不会让本地部署更便宜。第 2 章起将在此格局上展开具体模型的部署门槛实测与成本测算。
2. Qwen3.8-27B:个人可用的硬件门槛
本章先给结论:截至 2026-08,Qwen3.8-27B 是个人可本地部署模型中"能力/硬件需求比"最高的稠密模型,其"个人可用"门槛可划为三档——16GB 显存/32GB 统一内存能跑、24GB N 卡好用、RTX 5090 或 48GB 级满血。其中 24GB N 卡(RTX 3090/4090)是性价比拐点:Q4 量化加投机解码后 40-65 tok/s、32-64K 上下文舒适,整机投入约 2-3 万元级[8][5]。支撑这一结论的是两条硬件算术:Q4 权重仅约 17GiB,以及混合注意力架构把 262K 上下文的 KV cache 压到约 16GiB[29][46]。
2.1 规格与量化生态
2.1.1 架构规格:27.78B 参数、64 层混合注意力(48×Gated DeltaNet + 16×GQA)、262K 上下文可 YaRN 至 1M
Qwen3.8-27B 于 2026-08-03 发布、8 月 14 日开放权重,许可证 Apache 2.0(可商用、可修改、无营收门槛)[1]。精确存储参数量 27,781,427,952,隐藏维度 5,120、FFN 中间维度 17,408、词表 248,320(embedding 与 lm_head 不共享)[1]。架构上延续 qwen3_5 底座:64 层中 48 层为 Gated DeltaNet 线性注意力、16 层为 GQA 全注意力(24 个 Q 头/4 个 KV 头,head_dim 256),按"每 4 层一次全注意力"排布[1][47]。原生上下文 262,144 token,官方支持 YaRN 外推至 100 万,但官方同时警告静态 YaRN 会拉低短上下文表现、不建议默认开启[1]。训练时内置 1 层 MTP(Multi-Token Prediction,多 token 预测)头——这是后文投机解码加速 1.7-2.6 倍的硬件无关前提[1][5]。此外该模型为原生多模态(图像/视频输入),个人本地部署亦可覆盖视觉任务[1]。
混合架构对个人部署的直接价值在 KV cache 账目上:64 层中仅 16 层全注意力产生 KV,每 token 约 64 KiB(FP16),262K 上下文全开约 16GiB,FP8/q8_0 量化 KV 减半至约 8.7GiB[29][46]。若按同尺寸全注意力模型类推,262K 的 KV 需求约为此值的 4 倍(推算,约 64GiB),24GB 显存将完全无望。实际预算分配因此成立:Q4 权重约 16-17GiB + 长上下文 KV 数 GiB,恰好落入 24GB 卡;BF16 原始权重 55.6GB,个人硬件必须经过量化[2]。需要注意,KV 实际占用取决于推理引擎是否正确识别混合架构——未优化的引擎按全层分配会多出约 4 倍占用,这是社区实测数据差异的主要来源[46]。YaRN 外推至 1M 对个人硬件的实际意义有限:按 64 KiB/token 推算,1M 上下文的 KV 约需 61GiB,超出全部单卡个人设备的显存预算,262K 原生窗口才是实用上限[29]。
2.1.2 量化矩阵:官方 FP8 近无损;GGUF UD-Q4 为质量拐点;2-bit 仅适合试验
发布时官方仅提供 BF16 与官方 FP8 版(block size 128 细粒度量化,约 28GB,官方口径"性能指标与原始模型几乎完全一致")[48];GGUF/AWQ/MLX 等社区量化在两周内补齐,衍生变体达 319 个,其中 Unsloth Dynamic V3.0 获 Qwen 官方公开致谢[1][49]。下表汇总主流量化档位的体积与质量损失:
表 2-1 Qwen3.8-27B 量化档位—体积—质量损失对照(2026-08,GGUF 路线为主)
| 量化档位 | 体积 | 质量指标 | 判定 |
|---|---|---|---|
| BF16(原始) | 54.7-55.6 GB | 基准 | 仅工作站级 |
| 官方 FP8(block-128) | 约 28 GB | 官方口径近无损[48] | 48GB 级/vLLM 场景 |
| Q8_0 | 28.9 GB | KLD 0.00064,Top-1 一致率 98.92%[6] | 质量冗余,非必要 |
| Q6_K / AD-Q6_K | 22.9-25.0 GB | KLD 0.00107,Top-1 98.67%[6] | 余量充足时可选 |
| Q5_K_M / AD-Q5_K_M | 19.8-20.2 GB | KLD 0.00419,Top-1 97.34%[6] | 32GB 卡甜区 |
| UD-Q4_K_XL(Unsloth) | 17.9 GB | KLD 0.00955,4bit 最优[6] | 个人部署默认推荐 |
| Q4_K_M / AD-Q4_K_M | 17.1 GB | KLD 0.01126,Top-1 95.59%;PPL 相对 Q8 损失约 0.3%[6][50] | 24GB 卡甜区 |
| UD-Q3_K_XL / AD-IQ3_S | 13.4-13.8 GB | KLD 0.03247,Top-1 92.41%[6] | 16GB 设备可用,有可感知损失 |
| UD-IQ2_XXS(2-bit) | 9.0 GB | KLD 0.25663,Top-1 79.44%[6] | 仅试验/应急 |
| UD-IQ1_S(1-bit) | 约 6.2 GB | 保留约 77% 能力[49] | 尝鲜,8GB 内存可跑 |
表中 KLD 为输出分布相对 BF16 的 KL 散度(越低越好),Top-1 一致率为与 BF16 输出首位 token 的一致比例,均来自 AtomicChat 统一 held-out 测试[6]。其一,Q4 是明确的质量拐点——Q8 到 Q4 的 Top-1 一致率从 98.92% 缓降至 95.59%,而 Q4 到 Q2 骤降至 79.44%,误差曲线在 4bit 以下加速上扬[6];PPL 口径下 Q4_K_M 相对 Q8_0 的相对损失仅约 0.3%,可忽略[50]。其二,同为 4bit,不同量化作者差异显著:LM Studio Q4_K_M 的 KLD 为 0.02094,约为 Unsloth UD-Q4_K_XL(0.00955)的 2.2 倍——选量化作者比升一档位宽更重要[6]。其三,2-bit 对 30B 以下稠密模型仍未过"可用线":2026 年量化综述的共识是 2-bit 静态量化在基准上损失 10-20%,4-bit 仍是生产下限[51];Unsloth 1-bit 版虽能装进 8GB 内存,但仅保留约 77% 能力,属演示性质[49]。此外,针对 Blackwell 架构(RTX 50 系)另有 NVFP4 路线(约 23.4GB),借助 FP4 tensor core 比 BF16 快约 1.5 倍,RTX 5090 上 SGLang decode 可超 200 tok/s[9][52];MLX 4bit(约 15-18GB)则是 Apple Silicon 的默认容器[53]。
2.2 硬件实测与个人可用三档门槛
本章将"个人可用"定义为同时满足三条:decode 速度 ≥15 tok/s(高于常人阅读速度上限,交互不卡顿)、上下文 ≥32K 舒适 / ≥128K 为完整体验、量化损失可忽略(Q4 档及以上)。解读任何实测数字前需注意三大变量:量化格式(Q4_K_M 约 17GiB 为社区主流)、推理框架(llama.cpp 为个人部署主力,vLLM 0.27.1 对该模型有负优化报告[54])、以及投机解码——Qwen3.8-27B 原生 MTP 头在 llama.cpp 中开启 --spec-type draft-mtp 即可带来 1.7-2.6 倍提速,是同一张卡上最大的速度变量,且数学上不改变输出分布[5]。但 MTP 增益集中在代码/结构化/低温采样任务,温度 0.8 时接受率可从约 88% 崩至约 25%[5][55]。除 decode 外还有一条隐性门槛是 TTFT/prefill:长上下文下首次填充才是等待大头——RTX 5090 灌满 262K 需约 4.5 分钟,DGX Spark 100K 上下文 TTFT 约 90 秒[46][56]。
表 2-2 硬件档位—速度—上下文—个人可用判定(Qwen3.8-27B 实测,类推已标注)
| 硬件 | 典型配置 | decode tok/s(无投机 / +投机) | 舒适上下文 | 判定 |
|---|---|---|---|---|
| 16GB 独显(4060 Ti 16G 等) | Q3_K/IQ4_XS | 约 10-15 / — | 8-32K,需收着用 | ❌ 体验版,非主力 |
| M4 Pro / M5 Pro 48G | oMLX/MLX 4bit | 15-16 / 约 35-50(推算) | ≤32K(32K TTFT 达 97-113 秒) | ⚠️ 踩线达标[53] |
| Strix Halo 128G | Q4_K_M / ROCmFP4+MTP | 12.3-14 / 24.5(AMD 官方)-36 | 32K 日常;262K 可行 | ⚠️ 不开投机不达标[55][57] |
| DGX Spark 128G | Q4 / NVFP4+MTP | 8.8-11.6 / 21.4-23 | 262K 从容 | ⚠️ 达标但平淡[9][56] |
| RTX 3090 24G | Q4_K_M,llama.cpp | 31 / 41-53 | 32-64K(192K 勉强) | ✅ 达标[8][58] |
| RTX 4090 24G | Q4_K_M/AWQ | 35-45 / 55-65 | 32-128K | ✅ 甜区[8][59] |
| M4 Max 48/128G | MLX 4bit + MTP | 28-33 / 63(短上下文) | ≤16K 高速;31K 后断崖 | ✅ 有限达标[53] |
| RTX 5090 32G | Q4_K_XL / NVFP4+SGLang | 60-74 / 133-206 | 128K 内兼得;262K 需让渡 MTP | ✅✅ 完整体验[9][60][46] |
| 2×3090 / 2×4090 48G | FP8+MTP3,vLLM | 63 / 105-210(代码) | 128K+(长上下文衰减明显) | ✅ 完整体验[61][62] |
| RTX PRO 6000 96G | NVFP4+DFlash2 | 约 75(类推)/ 167.8 中位 | 262K 全开工况 | ✅✅ 天花板[63] |
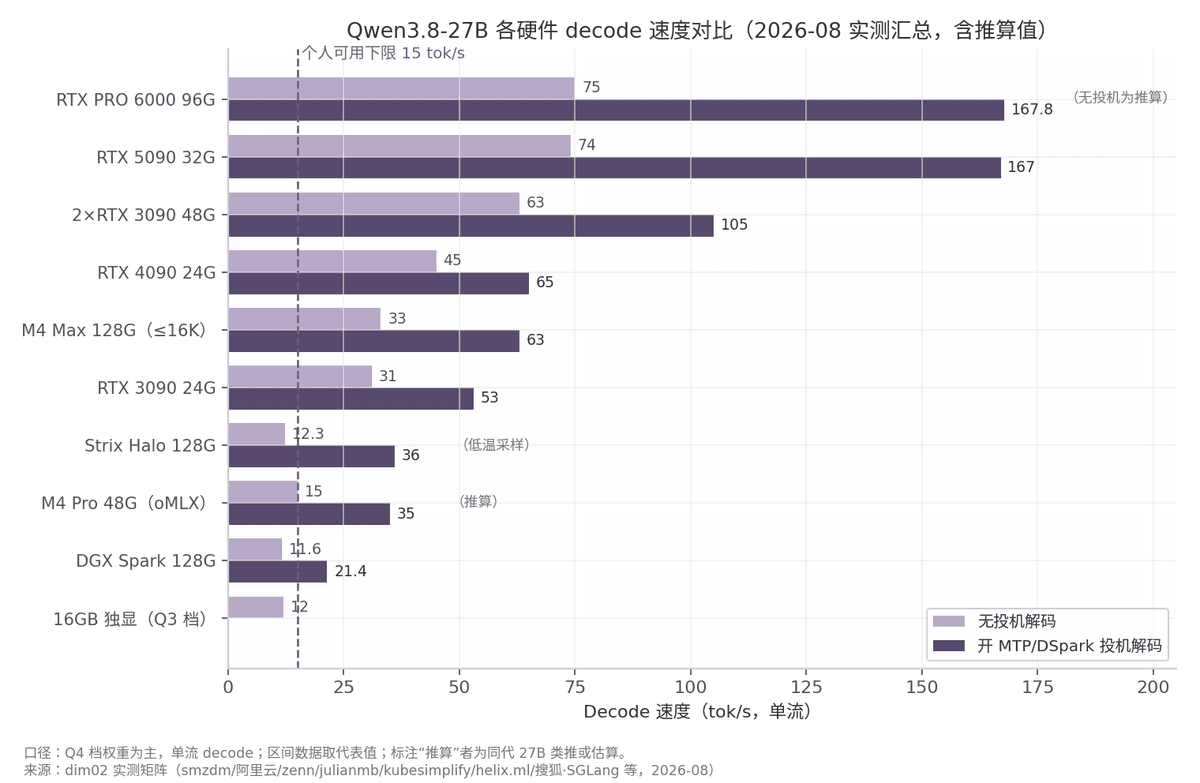
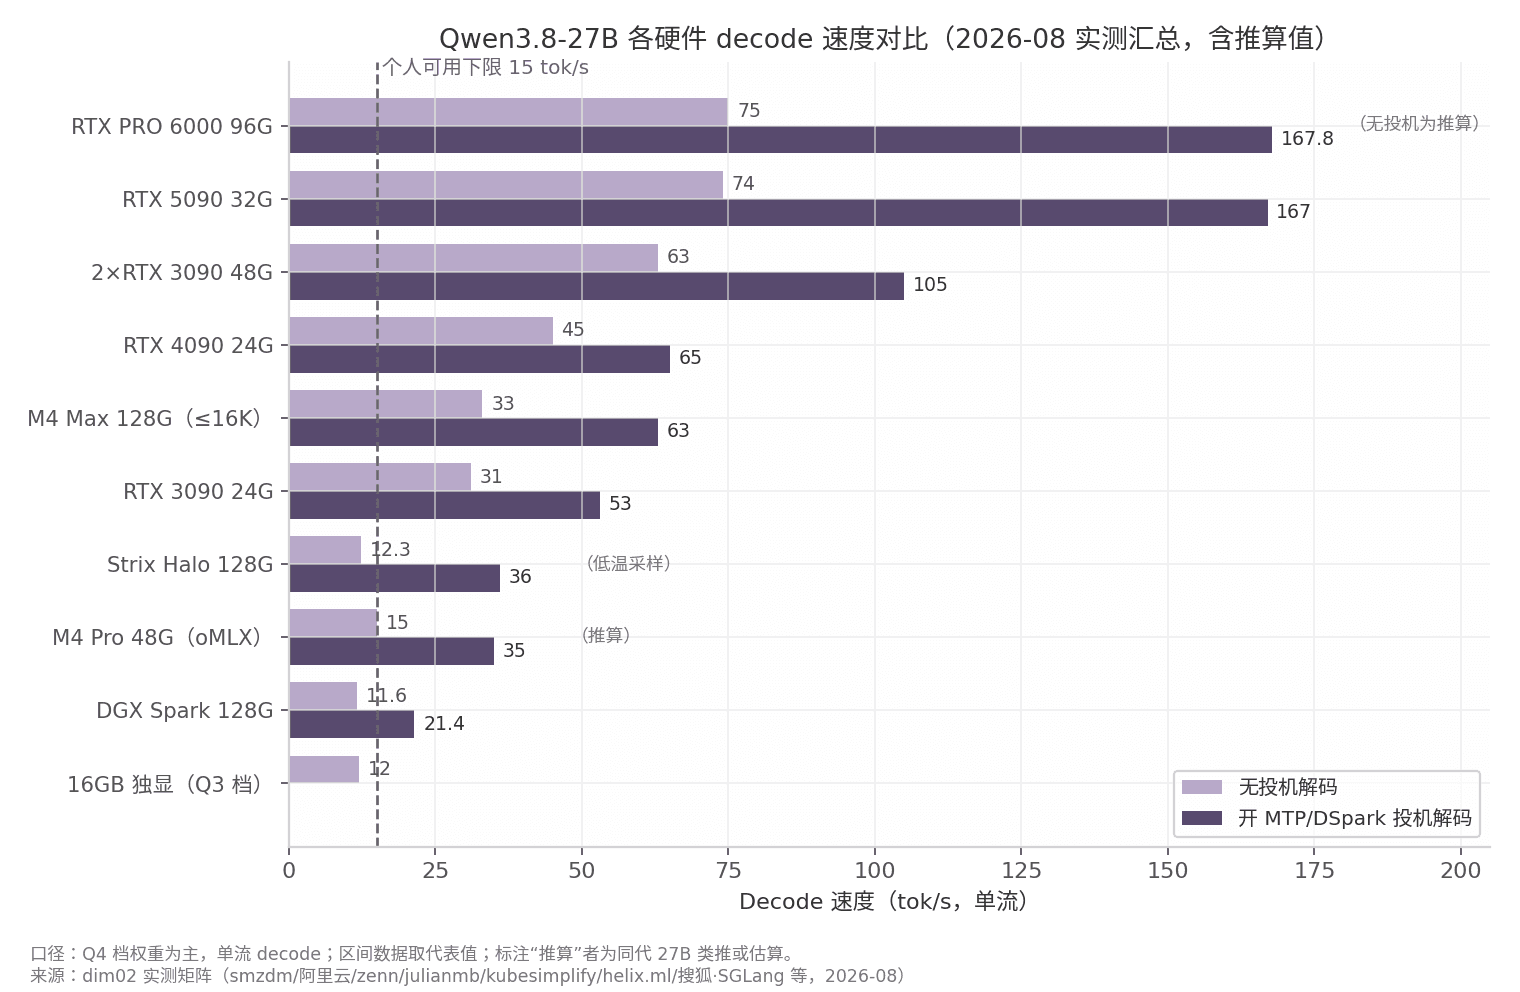
图 2-1 口径:Q4 档权重为主、单流 decode,区间数据取代表值,标注"推算"者为同代 27B 模型类推或估算。来源:smzdm/阿里云开发者/zenn/julianmb/kubesimplify/helix.ml/搜狐转引 SGLang 团队实测(2026-08)[8][9][46][63][55][56]。
图表与表格共同揭示两个结构性事实。第一,投机解码比硬件升级更便宜地抬升速度:从 3090 到 5090 的无投机速度仅提高约 1.4 倍(31→45-74 tok/s),而同一张卡开 MTP 即可获得 1.5-2.3 倍——软件红利约等于免费升级一代硬件[5]。第二,decode 速度几乎严格按内存带宽分档:统一内存设备(DGX Spark/Strix Halo,273GB/s 级)封顶在 20-40 tok/s,24GB GDDR6X 卡(约 1TB/s)在 40-65 tok/s,5090(1.8TB/s)在 133-206 tok/s——带宽每翻一倍,实测速度近似同比翻升,这正是稠密模型"每 token 须完整读取权重"的直接体现[46][56]。
2.2.1 能跑档:16GB 显存或 32GB 统一内存,10-15 tok/s,限短上下文
16GB 显存只能容纳 Q3/IQ4 档权重(约 13.4-15GB),留给 KV 的余量不足 2GB,实测 decode 约 10-15 tok/s,仅够 8-32K 上下文[58]。更低位数设备的实测同样悲观:M4 32G 基础款 MLX 4bit 仅 5-6 tok/s[53];12GB 显存卡(RTX 3060 级)跑 Q4_K_M 需将部分层 offload 至系统内存,速度进一步受损[64]。32GB 统一内存的表现类似:M4 Pro 48G 跑 oMLX Q4 约 15 tok/s,且 32K 上下文下 TTFT(首 token 延迟)达 97-113 秒,长文档场景不可用[53];16GB M4 机型 3-bit 版仅 3.7 tok/s,代码 Agent 实测全部失败[53]。此档判定为"体验版":可用于评估模型行为与轻量聊天,不构成生产力工具。
2.2.2 好用档:24GB N 卡(3090/4090)Q4+MTP 达 40-65 tok/s、32-64K 上下文舒适
24GB N 卡是当前性价比拐点。无投机时 Q4_K_M 在 3090 上约 31 tok/s、4090 上约 45 tok/s(Qwen3.6-27B 同卡类推 44 tok/s,几何一致[59]);开 MTP 后 3090 升至 41-53 tok/s、4090 达 55-65 tok/s,社区十余组实测汇总确认 24G 档(3090/7900 XTX/4090D)Q4 量化稳定在 40-53 tok/s 区间[8][58][5]。上下文方面,Q4 权重 17GiB 加 q4 KV 量化后,192K 上下文实测可跑在 22.6GB 显存内、decode 仍保持 59.5 tok/s(MTP3,一手实测)[65];专用引擎(NInfer)在 4090 上代码场景可达 148.6 tok/s,表明该卡上限远高于通用框架默认值[66]。横向对比进一步巩固该档定位:在 RTX 4090 24GB、Q4_K_M 同协议下,Qwen3.8-27B 与前代 Qwen3.6-27B 的速度/显存曲线完全打平(decode 均约 49 tok/s),但质量全面领先(编码 pass@1 12/12 对 8/12);对同尺寸的 Gemma 4 31B 则在显存余量与编码 Agent 任务上占优,实测方据此将其评为"24GB 单卡的最佳默认选择"[67]。综合判定:32-64K 上下文舒适、128K 可用,是"好用"与"能跑"的分水岭。
2.2.3 满血档:RTX 5090 128K 内 133-206 tok/s;48GB 级可 262K 全开
RTX 5090 32G 是单卡体验上限:无投机 60-74 tok/s,开 MTP 后统一协议实测约 133 tok/s、代码场景约 167 tok/s;SGLang 官方首日 NVFP4 + DSpark 投机下达 206.1 tok/s[9][60]。128K 以内 MTP 与长上下文可以兼得;262K 全开则存在硬性取舍:FP16 KV 单项即约 15.75GiB,加 Q4 权重合计约 32.4GiB,已超出 5090 的 31.84GiB 可用显存,KV 必须量化到 q8_0;量化后账面占约 28GiB,但运行时缓冲挤压使 MTP 无法同时启用,实测空载 decode 63.7-66.4 tok/s、灌入真实长文后降至 30.4 tok/s,且 262K prefill 需 4 分 27 秒[46]。需要 262K 全开且不妥协速度时,应上 48GB 级:RTX 4090 48G 改装卡可跑通 262K + MTP(Qwen3.6-27B 类推实测,短文本 68.6 tok/s)[68];RTX PRO 6000 96G 生产环境调优后中位 167.8 tok/s、最佳代码格子 332 tok/s,是当前实测天花板[63]。双卡方案(2×3090/4090)可达完整体验,但长上下文衰减明显:2×4090 FP8+MTP3 在 128K 下仅约 26 tok/s,性价比一般[61][62]。
2.2.4 避坑清单:Strix Halo/DGX Spark 跑稠密不达标;M4 Max 31K 后 decode 断崖
四类常见误判需提示。其一,Strix Halo(128G,256GB/s 级带宽)跑该稠密模型 stock 仅 12.3-14 tok/s,未达 15 tok/s 下限;深度优化(ROCmFP4 + MTP)可达 30.6-36 tok/s,但增益依赖低温采样,温度升高即回落至无投机水平(接受率骤降问题见 2.2 节)[55][57]。其二,DGX Spark 单流天花板约 23 tok/s(273GB/s 带宽的物理限制),SGLang 官方首日 NVFP4+DSpark 也仅 38.3 tok/s——买的是 128GB 容量与并发,不是速度[9][56]。其三,M4 Max 存在长上下文断崖:短上下文 63.1 tok/s,4-16K 稳在约 42 tok/s,31K 处骤降至 11.3 tok/s,结论为"16K 以内放心用"[53]。其四,框架版本有坑:vLLM 0.27.1 在 5090 上出现 decode 随上下文深度陡降的负优化(85.2→11.3 tok/s @32K),与 llama.cpp 上"几乎平坦"的实测相矛盾,个人部署现阶段首选 llama.cpp 或 SGLang[46][54]。
上述三档门槛均基于"27B 稠密 + 全量权重参与每 token 计算"的前提;若放宽架构约束,MoE(混合专家)路线每 token 仅激活少量参数,可在相同内存带宽下获得数倍速度——这是下一章 DeepSeek-V4-Flash 的主题。
3. DeepSeek-V4-Flash:个人可用的硬件门槛
第 2 章的结论是 27B 稠密模型的门槛由"显存容量"主导;本章面对的却是一个总参数量大十倍的模型。核心发现先行:DeepSeek-V4-Flash(284B 总参 MoE,激活 13B)的门槛结构已从"显存"转为"总内存 + 内存带宽",因而一台 128GB 统一内存设备即可跑出 20-35 tok/s 的可用速度——284B 反而比 70B 稠密更适合家用,这是架构而非预算的胜利。需要注意的口径前提是:这一结论只对量化压缩版成立,原生精度权重约 155GB,任何单机 128GB 设备都装不下[3][11]。
3.1 架构红利:为什么 284B 反而能在家跑
3.1.1 每 token 仅激活 13B:decode 带宽需求只由激活参数决定
V4-Flash 为 43 层混合专家(MoE)架构,含 256 个路由专家,每 token 仅路由激活其中 6 个、外加 1 个共享专家,激活参数约 13B[3][30];0731 正式版 checkpoint 因内置 DSpark 投机解码草稿模块,HF 元数据实数为 304.18B,与"284B 架构参数"是口径差而非矛盾[3]。decode(逐 token 生成)阶段每生成一个 token 只需从内存读出被激活的权重,按 13B 激活参数推算:Q4/FP4 级精度(约 0.55 字节/参数)下每 token 读取约 7-8GB,2-bit 级(约 0.30 字节/参数)约 4GB[14]。这意味着 decode 速度上限 内存带宽 每 token 激活权重字节数——与第 2 章 27B 稠密模型"每 token 读取全量约 16GB"相比,13B 激活让消费级内存带宽(256-1200GB/s)第一次够得着前沿级模型的可用速度线。对照实验是现成的:同一块 256GB/s 带宽的 Strix Halo,跑 70B 稠密模型只有 4.7-5.05 tok/s(已达理论上限的 94%,无优化空间)[69],跑 109B 总参、17B 激活的 Llama 4 Scout 却达 20.23 tok/s[70]——总参数更大、速度反而快 4 倍,差异完全来自激活参数。MoE 由此成为消费级带宽约束下的"架构解药":买硬件之前先选架构,比加预算更决定性。
两个伴随事实必须同时讲清。其一,"13B 激活不等于 13B 显存":全量 284B 专家权重必须常驻内存,容量门槛由总参数决定[11][31]。其二,DeepSeek 把 DSpark 草稿模块直接打进 checkpoint,官方自报在已加速的 MTP-1 基线上单用户生成速度再提升 60-85%、总吞吐 +51%(官方自报数据,无第三方复测)[37];llama.cpp 侧独立实测 DSpark 提速 1.84-1.91×[71]。投机解码从"用户技巧"变为"出厂配置",账面带宽需求可再打 5-6 折。
3.1.2 CSA+HCA 混合注意力:1M 上下文 KV cache 仅约 2-10GB
V4-Flash 的注意力栈由三层压缩叠加:MLA 式单 KV 头(64 个注意力头共享 1 个 KV 头)、CSA(压缩稀疏注意力,将连续 token 压缩 4 倍后由索引器选取 Top-512 个 KV 条目)、HCA(高压缩注意力,压缩率 128 倍),再辅以 128 token 滑动窗口分支保留局部精度[72]。官方口径下,1M 上下文时 V4-Flash 的 KV cache 仅为前代 V3.2 的 7%[41];实测锚点为每 token 约 6.9KB,即 1M token 约 6.9GiB[73],若启用 NVFP4 KV 量化可进一步降至约 2-3GB[41]。对照基线:V3.2 的传统 MLA 在 1M 上下文需约 83.9GB,更早的 GQA 稠密 70B 级模型则需数百 GB[74][7]。压缩的来源可以分解:单 KV 头贡献一个数量级,CSA 4 倍与 HCA 128 倍的序列压缩再贡献约两个数量级,KV 混合精度存储(RoPE 维度 BF16、非 RoPE 维度 FP8)最后砍掉近一半[7][41]。KV cache 从"长上下文的第一瓶颈"降格为个位数 GB 的零头,1M 上下文的瓶颈重新回到权重体积本身——这正是 CSA/HCA 的设计目标,且已达成。
3.1.3 量化路径:原生 155GB 与量化甜区 91-104GB 是两个档位
V4-Flash 官方权重本身是量化感知训练(QAT)产物:占参数约 96% 的路由专家原生以 MXFP4 存储,其余为 FP8/BF16,磁盘体积实测 155.4 GiB[11][31]。这带来一个独特的量化红利——Unsloth 可对 MXFP4 专家做逐位无损重打包,使 GGUF 路线首次出现"零量化误差"版本[11]。原生混合精度需 ≥192GB 加速器内存方可加载[4][75];而动态量化把门槛压进 128GB 设备:
表 3-1 DeepSeek-V4-Flash 主要量化路径:体积、质量与运行内存要求
| 量化方案 | 权重体积 | 质量(KLD,越低越好) | 建议总内存 | 定位 |
|---|---|---|---|---|
| 官方 MXFP4+FP8 原生 | ~155.4 GiB | 基线(0) | ≥192GB | 满血基准,2×H100/4×96GB 级 |
| Unsloth UD-Q8_K_XL | 162GB | ≈0(逐位无损) | 169GB(+DSpark 179GB) | 唯一完全无损 GGUF |
| Unsloth UD-Q4_K_XL | ~155GB | 0.0094(近无损) | 162GB | 近无损 |
| Unsloth UD-IQ3_XXS | 104.2GB | 0.2403 | 110-135GB | 官方推荐性价比甜区 |
| Unsloth UD-Q2_K_XL | 96.8GB | 0.2992 | 102GB+ | 128GB 设备甜区 |
| Unsloth UD-IQ2_M | 90.9GB | 0.3612 | 102GB(+DSpark) | 128GB 设备主力 |
| Unsloth UD-IQ1_S | 82.5GB | 0.4962 | 92GB | 极限最小,质量风险明显 |
| antirez ds4 IQ2(非对称) | 80.8 GiB | 无官方 KLD | ~96GB | 3090 级显存可 ~98% 常驻 |
数据来源:Unsloth 官方文档与 GGUF 仓库[11][71]、ds4 仓库[14];KLD 为相对无损 UD-Q8_K_XL 的 KL 散度。DSpark 草稿模块(Q8_0)另需约 10.9GB 权重与约 10GB 运行余量[11]。
表格揭示的关键结构是"体积断崖与质量缓坡并存":从 162GB 无损档到 91-104GB 甜区,体积压缩约 40%,而 KLD 仅从 0 升至 0.24-0.36——对 284B 这种冗余度极高的 MoE,2-3 bit 动态量化的质量损失远小于同位宽稠密模型,社区实测 2-bit 配方下 MMLU 仍可达 79.5、130K needle 检索 70/70[76]。但再往下到 1-bit(82.5GB),KLD 0.4962 对应"质量风险明显",只适合极限实验[11]。甜区之所以成立,机理在于非对称量化:路由专家占参数大头但每个专家每次只服务少量 token,对激进量化不敏感;而 attention、共享专家与路由器一旦低 bit 化损失立刻放大,因此主流方案都把专家压到 2-3 bit、把关键张量保在 Q8[14][11]。同时须警惕伪造量化:社区已出现"284B Q4_K_M 仅 7.5GB、8GB 显卡跑 65 tok/s"这类物理上不可能的内容农场数据[31],选量化版本应认准 Unsloth/ds4 等有逐张量校验记录的分发。
3.2 硬件实测与个人可用三档门槛
沿用第 2 章的"能跑/好用/满血"三档框架,阈值按 284B 级 MoE 的实测分布划定(第 2 章 27B 稠密档的"个人可用"线为 decode ≥15 tok/s、上下文 ≥32K,本章不做机械平移):能跑 = decode ≥10 tok/s 且上下文 ≥22K;好用 = decode ≥20 tok/s 且 128K 上下文舒适;满血 = 512K-1M 上下文可用(接受以分钟计的长 prefill)。
3.2.1 能跑档:128GB 统一内存,量化版 20-35 tok/s
128GB 统一内存是 284B 级模型进入家庭的绝对下限,三条平台路线均有实测锚点:MacBook Pro M3 Max 128GB 在 ds4 引擎(2-bit、32K 上下文)下生成 26.68 tok/s[77],汇总实测中 M5 Max 128GB 约 34 tok/s[78];AMD Strix Halo 128GB(Ryzen AI MAX+ 395,256GB/s)在自研 ROCm 栈 + DSpark 下最高 32 tok/s,通用 Vulkan 栈约 15.6-19 tok/s,Framework 社区多人独立报告 100K-500K 上下文下 20-30 tok/s[12][79];NVIDIA DGX Spark 单台短上下文 26.7 tok/s,但 131K 上下文降至 12-15 tok/s[80][81]。GPU+大内存混合路线同样归入此档:RTX 5090 32GB + 192GB DDR5 主机经 FreeToken 混合执行持续 decode 22-25 tok/s(arXiv 论文,有一例第三方复现)[82];二手服务器 + 双 RTX 3090 达约 33 tok/s,但上下文仅 22K[83]。此档上下文甜区为 64-128K:64K 起步稳定、128K 需验证、256K 属实验性,1M 无操作余量[76]。能跑档还存在一个"理论下限展示":64GB Strix Halo 通过 mmap + NVMe 流式加载 81GB 的 2-bit 权重,decode 仅约 1.9 tok/s[14]——它证明"装不下"可以用存储换,但速度已跌破任何实用定义,只具演示意义。需要说明的是,能跑档 20-35 tok/s 的区间上限依赖 DSpark 或优化引擎:通用 llama.cpp/Vulkan 栈下 Strix Halo 与 Spark 多落在 12-19 tok/s,处于"可用但不流畅"的灰区[12][80]。
3.2.2 好用档:M5 Ultra 256GB 或 96GB 级 GPU
好用档的容量下限是 256GB,这笔账是刚性的:原生或近无损权重约 155-162GB,加 128K-256K 上下文的 KV(CSA/HCA 架构下约 1-3GB)与框架运行时余量 20-40GB,再留 DSpark 草稿约 21GB,128GB 与 192GB 级设备均无舒适余量[11][76][75]。在此之上,好用档有两条气质迥异的路线。统一内存路线:2026-08-25 发布的 Mac Studio M5 Ultra(256GB / 1.2TB/s 带宽)按带宽推算可达 55-75 tok/s(推算值:以 M3 Ultra 819GB/s 上 22B 激活的 Qwen3-235B 实测 24-30 tok/s、13B 激活在 1.2TB/s 上的带宽比例外推,截至 2026-08-29 无第三方实测,9 月 22 日才发货)[21][84];预算敏感的替代是二手 M3 Ultra 512GB,实测 27-37 tok/s[77][78][85]。GPU 路线:单张 RTX PRO 6000 96GB 依引擎不同落在 43.6 tok/s(自研 CUDA 后端)至 161 tok/s(vLLM-Moet 实验性 2-bit 方案)区间[86][87];4× RTX 4090(96GB 总显存,SM89 补丁 + vLLM)原生 decode 约 82 tok/s,开启 DSpark 后 8K 输入下达 367 tok/s、128K 下 219 tok/s,768K 上下文可完整跑完[13]——这是当前实测速度最强的个人方案,代价是四卡主机的功耗与采购复杂度。
3.2.3 满血档 1M 上下文:双 DGX Spark、双 H100 与 512GB Mac
消费级唯一实测达成 1M 上下文的组合是双 DGX Spark(TP2,200Gbps QSFP 直连):1M 上下文下 41 tok/s(冷启动 41.8 / 热 41.1),512K 输入的 TTFT 约 334 秒[80];另一独立仓库在 NVFP4 KV 路线下录得 1M 上下文单流 55-82 tok/s,但自承未做满 1M 检索正确性验证,两组数字的口径差异在于"最大可配上下文"与"短 prompt 速度"非同一次测量[88][81]。数据中心级参照:2× H100 80GB 在 vLLM 官方路径下 decode 66.9 tok/s 且 1M 可启动[89];8× A800 单流 40.6 tok/s[90]。512GB Mac 属于"容量满血、速度能跑"的特殊形态:M3 Ultra 512GB 实测生成 27.39 tok/s[77],但该机型的 512GB/256GB 选项已于 2026 年 3-5 月相继停产,仅剩二手与翻新渠道[91]。
表 3-2 V4-Flash"个人可用"三档门槛:配置、速度与上下文对照
| 档位 | 代表配置 | 量化/引擎 | 实测 decode | 舒适上下文 | 证据性质 |
|---|---|---|---|---|---|
| 能跑 | 128GB 统一内存(M3/M5 Max Mac、Strix Halo、DGX Spark);或 RTX 5090 + 192GB DDR5;极限:双 3090 + 768GB DDR4 | IQ2_M ~91GB / Q2_K_XL / FreeToken 混合 | 20-35 tok/s(Mac 26.7-34;Strix Halo 15.6-32;Spark 12-27;混合 22-33) | 64-128K(Spark 长上下文衰减至 12-15 tok/s) | 多源实测[77][12][82][80] |
| 好用 | Mac Studio M5 Ultra 256GB;或 1-2× RTX PRO 6000 96GB;或 4× RTX 4090 96GB | 4-bit/MXFP4 + MTP/DSpark | M5 Ultra 推算 55-75;PRO 6000 43.6-161;4×4090 82-367 | 128-256K 舒适,768K 可跑完 | M5 Ultra 为推算[21],余为实测[13][86] |
| 满血 | 双 DGX Spark TP2;2× H100 80GB;512GB Mac(二手) | FP8/NVFP4 + DSpark | 双 Spark 41 @1M;2×H100 66.9;M3 Ultra 512GB 27.4 | 512K-1M(512K TTFT 约 5.6 分钟) | 实测[80][89][77] |
三档之间的跃迁逻辑值得展开:能跑档到好用档的本质是把带宽从 256-614GB/s 抬到 1.2TB/s 级或引入 GDDR6X/7 显存带宽,decode 从 20-35 抬到 43-367 tok/s;好用档到满血档的本质则不再是速度,而是总内存——1M 上下文需要原生权重(约 155GB)加 KV 与运行时余量,256GB 成为事实下限[76]。异常点有两个:其一,4×4090 的 367 tok/s 远超同档其他方案,原因是 DSpark 在短输入下的投机收益最大化(8K 输入),随上下文拉长衰减至 219 tok/s(128K)[13];其二,双 Spark 的 41 tok/s@1M 与其短 prompt 82.4 tok/s 的落差提示:长上下文下 decode 会因 KV 读取与互联开销显著退化[80][81]。对个人用户更实际的"满血甜区"是 256K-512K,1M 的价值主要在"可启动"而非"高吞吐"——满长 prefill 在消费硬件上以分钟计(双 Spark 512K 输入 TTFT 约 5.6 分钟),交互式场景难以容忍,更适合批处理式的长文档离线分析[80]。
3.2.4 带宽测算公式:20/40/60 tok/s 约需 150/300/450 GB/s
把 3.1.1 的机理写成可计算的公式(推算,Q4/FP4 级精度、未含投机解码收益):
其中 为内存带宽, 为激活参数量, 字节/参数, 为投机解码加速系数[14][71]。代入得:目标 20/40/60 tok/s 分别约需 150/300/450 GB/s(Q4 级、不开 DSpark);2-bit 权重或开启 DSpark 可各打约 5-6 折。该测算的价值在于可证伪性——它给出的是上限,实测值与上限之间的缺口即引擎开销。五组独立实测与测算的量级吻合:Strix Halo 256GB/s → 实测 15.6-32 tok/s[12];DGX Spark 273GB/s → 12-27 tok/s[80][81];M3 Ultra 819GB/s → 27-37 tok/s(引擎开销约吃掉理论值的三分之一)[77][85];RTX 5090 + DDR5 混合方案瓶颈在主机内存 80-90GB/s,经专家缓存等效放大后实测 22-25 tok/s[82];RTX PRO 6000(GDDR7 1792GB/s 全载)→ 43-161 tok/s[86][87]。五组数据横跨 256GB/s 到 1792GB/s 近一个数量级,测算的方向与量级均未被推翻;缺口最大的是 M3 Ultra(理论上限约 110 tok/s,实测仅 27-37),主因是 MLX/llama.cpp 系引擎的调度与反量化开销,而非带宽本身——这意味着同一硬件仍有约 3 倍的软件优化空间,M5 Ultra 的推算区间也因此偏向保守[85][21]。
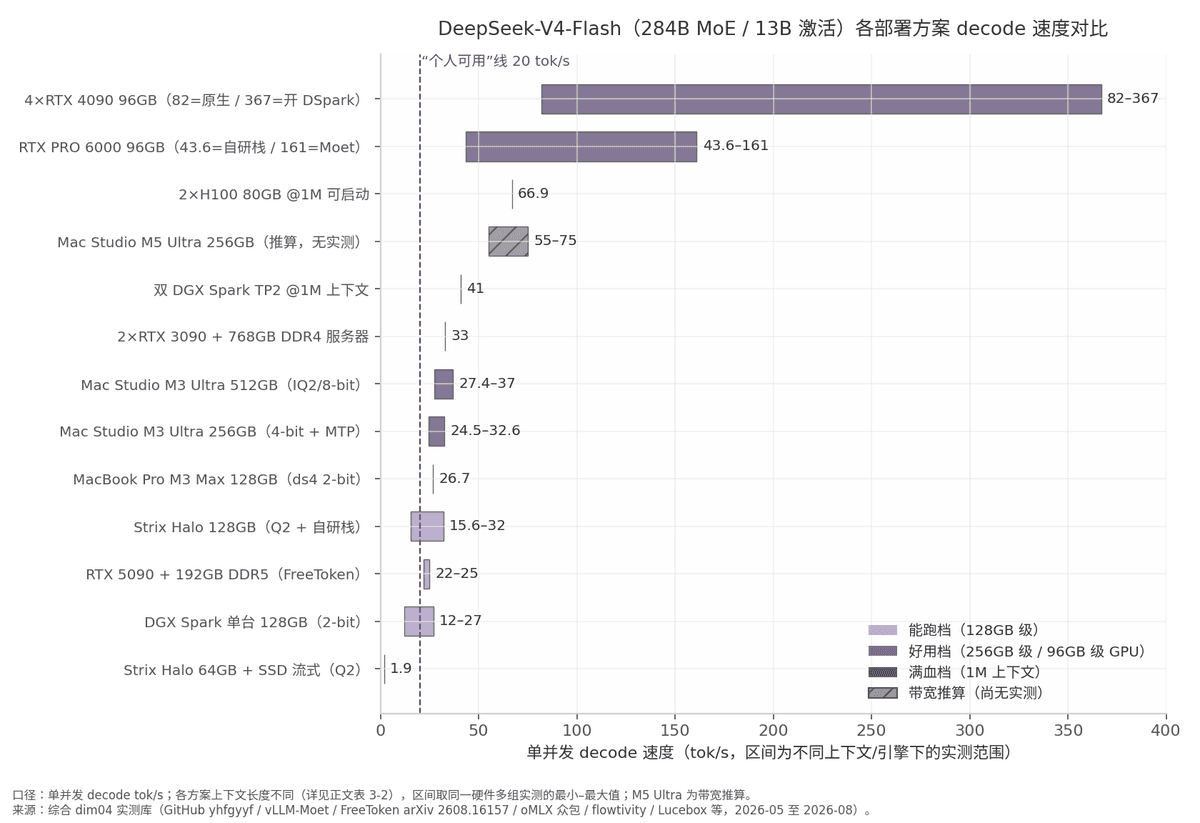
图 3-1 各部署方案单并发 decode 速度。口径:2026-05 至 2026-08 社区实测汇总,区间为同一硬件在不同上下文/引擎下的最小-最大值;M5 Ultra 为带宽推算(hatch 纹);虚线为"个人可用"20 tok/s 判定线。来源:GitHub yhfgyyf/vLLM-Moet、FreeToken(arXiv 2608.16157)、oMLX 众包、flowtivity、Lucebox、ds4 等[77][12][82][80][13][86]。
带宽公式给出本章的收尾判断:V4-Flash 的硬件门槛本质是一道带宽×容量的算术题,而非 GPU 算力题——这也是 128GB 统一内存设备能跑赢单张旗舰显卡的结构性原因,与第 2 章 27B 稠密路线"显存容量决定一切"形成镜像对照。三档门槛对应的预算区间(约 ¥1.4-3.4 万能跑、¥4.5 万-15 万好用与满血),将在第 4 章换算为成本与回本周期。
4. 成本测算与回本周期
本章把第 2、3 章确立的硬件门槛换算为 2026 年 8 月时点的整机预算,并构建对照云端 API 与订阅制的回本模型。核心发现先行:在内存/显存超级涨价周期下,硬件一次性投入较 2025 年行情上浮约 30–135%,而云端推理价格持续走低,"本地部署是否划算"的答案高度依赖参照系——对照 DeepSeek 官方直连 API,任何档位硬件在个人用量下永不回本;对照旗舰 API 或高端订阅,重度用户的回本窗口可压缩至 8–15 个月。下文所有价格均为 2026-08 时点行情,币种以人民币(CNY)为主、美元(USD)附注,汇率按 1 USD ≈ 7.1 CNY 估算。
4.1 硬件分档预算(2026-08 行情)
4.1.1 四档整机预算
沿用第 2、3 章的分档命名:A 档(27B 舒适,≈24–32GB N 卡整机)、B 档(27B 满血长上下文,≈48GB 显存或 128GB 统一内存)、C 档(284B-MoE 能跑,≈128GB 统一内存小主机)、D 档(284B-MoE 好用,≈192GB+ 统一内存或多卡)。2026 年 8 月的特殊背景是 DRAM/GDDR7 合约价同比 +92%、消费级内存条较 2025 年涨约 300%,所有预算均应视为"涨价周期内的高水位坐标"[44][26]。
表 4-1 A/B/C/D 四档整机预算表(2026-08,人民币)
| 档位 | 代表配置 | 显存/内存 | 核心件价格 | 整机总价 | 约合 USD | 对应能力 |
|---|---|---|---|---|---|---|
| A | RTX 4090 24GB 单卡整机 | 24GB | 卡 15,000–17,000(全新库存,二手倒挂至 19,000–21,000)[92] + 准系统 6,000–9,000 | ¥21,000–26,000 | $3,000–3,700 | 27B Q4+MTP 40–65 tok/s |
| A | RTX 5090 32GB 单卡整机 | 32GB | 卡 27,500–36,400(京东自营涡轮 34,999 起)[93][94] | ¥30,000–45,000 | $4,200–6,300 | 27B FP8、128K 内 133–206 tok/s |
| B | RTX 4090 48GB 魔改单卡整机 | 48GB | 卡 19,999–23,999(京东自营/秒杀)[95][96] | ¥28,000–38,000 | $3,900–5,400 | 27B FP8 从容 + 262K 上下文 |
| B | Mac Studio M4 Max 128GB | 128GB UMA | 官网已下架,第三方 128GB/4TB 报 ¥35,670(无货,排产 8–12 周)[97][98] | ¥30,000–36,000 | $4,200–5,100 | 27B 约 22–28 tok/s,静音低功耗 |
| C | Strix Halo 128GB 迷你机(铭凡/玲珑/极摩客) | 128GB UMA | 整机 ¥13,999–15,999(国行预售/众筹价)[99];海外同配已涨至 | ¥14,000–16,000 | 2,000–2,300 | 284B 量化版 20–35 tok/s |
| C | NVIDIA DGX Spark(128GB/4TB) | 128GB UMA | 国内 ¥33,800–34,899;美国 $4,699(2026-02 上调 18%)[100] | ¥33,800–35,000 | $4,800–4,900 | 284B 量化版 + CUDA 全栈 |
| D | Mac Studio M3 Ultra 192GB | 192GB UMA | 美国 $5,499–6,999;国内定制估 ¥45,000–55,000(256GB 已下架)[97][101] | ¥45,000–55,000 | $6,300–7,700 | 284B 单用户长上下文 |
| D | 双 RTX 4090 48GB(96GB 池) | 96GB | 卡 2×24,000 + 1600W 双路平台 ≈12,000 | ¥55,000–65,000 | $7,700–9,200 | 284B Q4、70B FP8 |
| D | 4×RTX 4090 48GB 机架服务器(192GB) | 192GB | 淘宝整机一口价 | ¥150,499[102] | ≈$21,200 | 284B Q4 从容、235B 直跑 |
注:二手路线(双 3090 48GB 池整机 ¥10,000–14,000)可使 A 档成本降低 30–50%,但流通卡多为过保高负载卡,需自担矿卡风险[103]。
分析解读: 其一,A 档内部出现罕见的价格倒挂:2026-07 起二手 RTX 4090 成交价(19,000–21,000 元)反超全新库存(15,000–17,000 元),买新卡多花的钱实际购买的是 3 年官方质保与零矿卡风险[92];而 RTX 5090 国内成交价已达首发指导价的 1.8–2.3 倍,美国市场较 $1,999 MSRP 溢价 135%[93][10],A 档上沿因此被顶到 4.5 万元。其二,C 档是唯一出现"中外价差倒挂"的档位:国行 Strix Halo 128GB 机型维持在 1.4–1.6 万元,而海外同配因 DRAM 合约价传导已涨至 $3,449–3,649(约合 ¥2.4–2.6 万),国行预售定价尚未完全反映涨价,存在随时调价的风险[99][103]。其三,B 档与 C 档预算区间高度重叠(约 3 万元)但能力完全不同——B 档买的是 27B 的带宽与上下文从容度,C 档买的是 284B 的模型层级;这一重叠正是"先选模型架构、再定预算"原则在采购端的直接体现。
4.1.2 持有成本:电费、残值与隐藏项
一次性投入之外,三年持有期的电费与残值决定真实净成本。功耗基准取推理负载整机墙端功率:4090 整机约 550W、5090 整机约 700W(非公实测满载 620W、峰值 717.6W)[104]、4090 48GB 魔改整机约 600W[96]、M4 Max 持续满载约 120W、M3 Ultra 约 260–300W[101]、Strix Halo 推理典型约 130W(cTDP 45–120W)[105]、DGX Spark 实测约 100–181W[100]。电价取居民 0.55 元/kWh、工商业 0.9 元/kWh 两档[106]。
表 4-2 年持有成本与三年净成本估算(2026-08,人民币)
| 档位-代表配置 | 典型功耗 | 年电费@4h/天(居民) | 年电费@8h/天(居民) | 年电费@24h/天(居民/商用) | 3 年残值率(经验值) | 3 年净持有成本(推算) |
|---|---|---|---|---|---|---|
| A-RTX 4090 整机 | 550W | 442 | 883 | 2,650 / 4,336 | 40–60%[107][108] | ≈¥14,400(总价取 23,500、残值 50%、8h/天) |
| A-RTX 5090 整机 | 700W | 562 | 1,124 | 3,373 / 5,519 | 40–60% | ≈¥22,100(总价取 37,500、残值 50%) |
| B-4090 48GB 魔改 | 600W | 482 | 964 | 2,891 / 4,730 | 40–50%(无官保折价) | ≈¥21,000(总价取 33,000、残值 45%) |
| B-M4 Max 128GB | 120W | 96 | 193 | 578 / 946 | 50–60%(个人二手市场)[107] | ≈¥17,100(总价取 33,000、残值 50%) |
| C-Strix Halo 128GB | 130W | 104 | 209 | 626 / 1,025 | 30–40%(内存焊死、迭代快) | ≈¥10,400(总价取 15,000、残值 35%) |
| C-DGX Spark | 180W | 145 | 289 | 867 / 1,419 | 30–40% | ≈¥23,000(总价取 34,000、残值 35%) |
| D-M3 Ultra 192GB | 300W | 241 | 482 | 1,445 / 2,365 | 35–55%[107] | ≈¥28,900(总价取 50,000、残值 45%) |
| D-双 4090 48GB | 1,100W | 883 | 1,767 | 5,300 / 8,672 | 40–50% | ≈¥38,300(总价取 60,000、残值 45%) |
| D-4×4090 48GB | 2,300W | 1,847 | 3,694 | 11,081 / 18,133 | 40–50% | ≈¥94,000(总价取 150,000、残值 45%) |
注:净持有成本 = 整机总价 ×(1−残值率)+ 3 年电费(8h/天居民电价口径),为本章按上表参数的推算值;未含夏季制冷附加(24h 高功耗档年增约 500–1,500 元)与运维时间成本。
分析解读: 统一内存平台与独显多卡方案的电费差距达 5–10 倍:M4 Max 在 8 小时/天强度下年电费仅 193 元,而双 4090 48GB 同强度需 1,767 元、24 小时商用场景下 4 卡服务器年电费可超 1.8 万元(约占硬件总价 12%)。对 24 小时常驻的 Agent 工作负载,电费开始反向影响选型——C 档统一内存方案的年电费(626–1,025 元)甚至低于部分用户一个月的云端订阅费。残值侧出现一个反常信号:本轮 AI 景气使大显存卡"越用越值钱",RTX 4090(MSRP ¥12,999)发布 3.5 年后新卡反而涨至 15,000 元以上、二手 19,000–21,000 元,实现事实上的三年零折旧[92];这与常规游戏卡首年折价约 40% 的经验曲线[108]、以及数据中心卡 3 年残值约 30% 的 TCO 样本(8×H100 整机 25 万购入、3 年后 7.5 万转手)[109] 形成鲜明对照。Mac 阵营残值同样坚挺:企业回收口径 3 年 22–28%,个人二手市场可达 50–60%[107]。综合看,4090/5090 级取 40–60%、Strix Halo 迷你机取 30–40%、Mac Studio 取 35–55% 的 3 年残值假设是当前行情下的审慎区间(推算)。
隐藏成本集中在四类:① 电源与电路——5090 需 1000–1200W ATX3.1 电源(12V-2×6 接口熔毁事故多发),双卡/四卡需 1600W/3000W 冗余,而家用 16A 插座上限约 3.5kW,4×4090 满载已逼近家庭回路极限;② 噪音——涡轮版 4090 48GB 满载 65 分贝/5000RPM(舒适区 30–40dB),实质要求独立房间或机柜,改水冷需加 500–3,000 元[94];③ UPS 与机架——后备式 1500VA UPS 约 200–680 元,4 卡服务器需 3kVA+ 在线式(1,600 元起)及 4U 机柜(1,000–5,000 元)[110];④ 质保期望成本——魔改 48GB 卡无官方保修、故障率约 2%,"一次翻车即数千元维修"应计入期望成本[94]。这些项目合计通常占整机预算的 3–8%,D 档高配可超 10%。
4.2 云端对照与回本模型
4.2.1 价格谱系:三个数量级的参照系
本地部署的经济性完全取决于"不买硬件的话,钱会花给谁"。2026 年 8 月核实的价格谱系横跨三个数量级:
表 4-3 云端参照系价格谱系(2026-08 核实)
| 层级 | 参照对象 | 价格(每百万 token,输入/输出) | 说明 |
|---|---|---|---|
| 地板价 | DeepSeek V4-Flash 官方直连 | $0.14 / $0.28(缓存命中输入仅 $0.0028,-98%)[15] | 人民币高峰 3/9 元、低谷减半;2026-08 起峰谷计价、周末全天低谷[16] |
| 中档 | 阿里百炼 Qwen3.8-27B | ¥3 / ¥12(缓存命中 ¥0.6)[17] | 与本地 A/B 档同模型的直接对照 |
| 旗舰 | Qwen3.8-Max | ¥12 / ¥36(≈$2/$6 国际目录价)[111] | 闭源旗舰,2.4T 参数 API-only |
| 旗舰(第三方托管) | V4-Pro @ Fireworks / Together | $1.74–2.10 / $3.48–4.40[112][113] | 同模型官方直连价($0.435/$0.87)的 4 倍 |
| 订阅制 | Claude Max 5x / 20x | $100 / $200 每月(≈¥710 / ¥1,420)[18] | SemiAnalysis 实测 20x 档月耗等效 API 价值最高约 $8,000[114] |
| 订阅制(入门) | Copilot Pro / Cursor Pro / Claude Pro | $10 / $20 / $20 每月[18][115][116] | 额度制,重度编码易撞限 |
分析解读: 谱系的最大特征是"同模型价差大于跨模型价差":V4-Flash 官方直连价已把按量 API 压到订阅价以下(重度 3 亿 token/月用户月账单仅约 ¥113),而同一模型在第三方托管平台价格可达其 4 倍[112][113]。订阅制的本质则是"看跌期权"——Anthropic 官方口径下 Claude Code 重度用户按 API 折算月耗 $200–800,Max 订阅封顶 $200;有开发者 8 个月消耗 100 亿 token(API 等效 800[114][117]。这意味着回本测算若选错对标物(按 API 标价而非用户实付),结论会严重失真。同时需注意 2026 年 API 价格整体处于上行通道(智谱累计 +83%、DeepSeek 引入峰谷计价)[118],谱系应以季度为周期刷新。
4.2.2 用量画像
回本测算的输入端是月 token 用量。真实用量锚点来自 Vibe Usage 平台 2026 年 4–7 月对 98 名编程 Agent 用户的实测:OpenCode 用户月均 1.27 亿 token、Claude Code 用户月均 1.6 亿、OpenClaw 用户 1.86 亿;Claude Code 场景缓存命中率高达 91%(OpenCode 67%)[119]。据此定义三档画像:轻度 5M token/月(问答与偶发辅助)、编程中度 30M–100M token/月(日常编码助手重度使用)、重度 Agent 300M+ token/月(多 Agent 并行、全库重构、自动化流水线,约为实测均值的 2 倍,对应头部用户)。账单估算统一采用编程场景输入:输出 = 10:1、缓存命中率 80% 的口径;通用场景按 5:1 估算时,各档账单约上浮 40–90%(推算)。
4.2.3 回本月数矩阵与"回本悖论"
回本公式定义为:
硬件侧取三个代表价位:2 万元档(A 档 RTX 4090 24GB 单卡整机,跑 27B 量化版 40-65 tok/s,月电费约 ¥70)[120]、5 万元档(D 档双卡 96GB 级,月电费约 ¥150)、10 万元档(D 档高配 192GB 级,月电费约 ¥200)。月云端等价支出按 4.2.2 口径折算。
表 4-4 用量 × 档位 × 参照系回本月数矩阵(单位:月;"—"= 月支出 ≤ 电费,永不回本)
| 月用量 | 对照价目(月支出) | 2 万档(A) | 5 万档(D 双卡) | 10 万档(D 高配) |
|---|---|---|---|---|
| 5M | V4-Flash 官方(¥2) | — | — | — |
| 5M | Qwen3.8-27B 百炼(¥10) | — | — | — |
| 5M | Qwen3.8-Max(¥43) | — | — | — |
| 30M | V4-Flash 官方(¥11) | — | — | — |
| 30M | Qwen3.8-27B 百炼(¥62) | — | — | — |
| 30M | Qwen3.8-Max(¥256) | 108 | 472 | 1,786 |
| 100M | V4-Flash 官方(¥38) | — | — | — |
| 100M | Qwen3.8-27B 百炼(¥207) | 146 | 877 | ≈14,286 |
| 100M | V4-Pro 托管价(¥524) | 44 | 134 | 309 |
| 100M | Qwen3.8-Max(¥852) | 26 | 71 | 153 |
| 300M | V4-Flash 官方(¥113) | 465 | — | — |
| 300M | V4-Pro 官方(¥343) | 73 | 259 | 699 |
| 300M | Qwen3.8-27B 百炼(¥622) | 36 | 106 | 237 |
| 300M | V4-Pro 托管价(¥1,572) | 13 | 35 | 73 |
| 300M | Qwen3.8-Max(¥2,556) | 8 | 21 | 42 |
| 订阅 | Copilot Pro(¥71/月) | ≈20,000 | — | — |
| 订阅 | Cursor Pro / Claude Pro(¥142/月) | 278 | — | — |
| 订阅 | Claude Max 5x(¥710/月) | 31 | 89 | 196 |
| 订阅 | Claude Max 20x / Cursor Ultra(¥1,420/月) | 15 | 39 | 82 |
注:加粗 = 回本 ≤36 个月(落入硬件 3 年折旧期),经济性成立。矩阵沿用 dim10 测算:电价 ¥0.7/kWh、输入:输出 10:1、缓存命中 80%;未计残值(按 65% 净值修正可将回本月数打约 65 折)与运维成本。
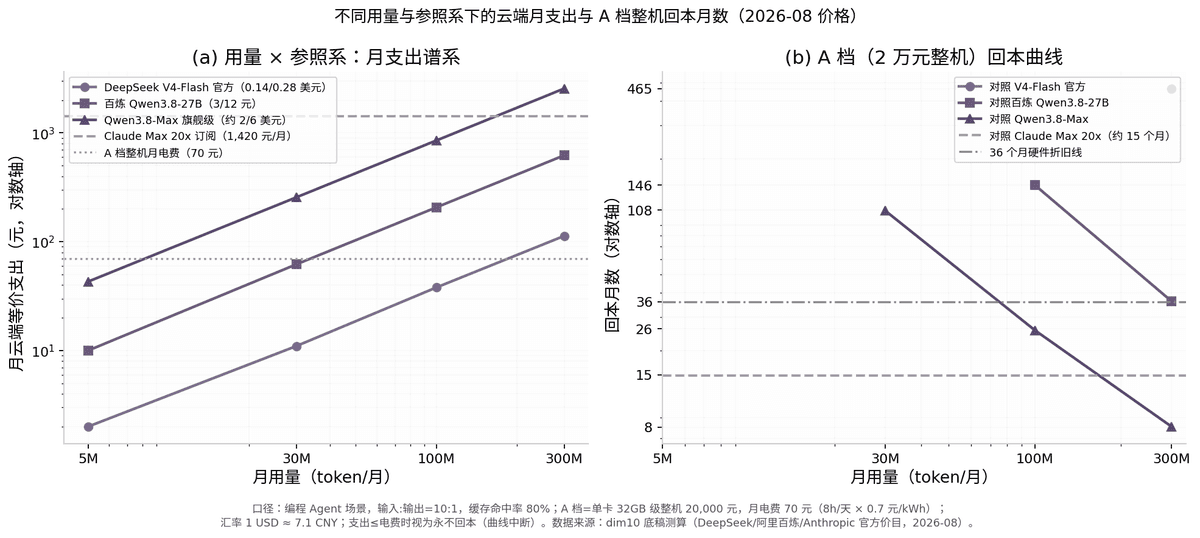
图 4-1:(a) 三档用量画像下各参照系的月云端等价支出;(b) A 档(2 万元整机)相对各参照系的回本月数。曲线中断处表示云端支出低于月电费、永不回本。口径与假设见图内脚注;数据来源:DeepSeek/阿里百炼/Anthropic 官方价目(2026-08)[15][17][111][18]。
矩阵揭示"回本悖论":本地部署能否回本,主要取决于参照系而非硬件本身。 对照 DeepSeek 官方直连价,重度用户月账单(¥113)与 2 万档月电费(¥70)处于同一量级,最优情形也需 465 个月——任何档位、任何个人用量下永不回本;即便叠加 2026-08 峰谷新规使高峰账单翻倍(约 ¥226/月),2 万档回本仍需约 128 个月,依然不成立[16]。对照系每上移一层,结论翻转一级:对照同模型百炼 API,重度用户 2 万档 36 个月回本,勉强卡入折旧期;对照旗舰 API(Max 级)或第三方托管价,回本压缩至 8–13 个月;对照 Claude Max 20x 订阅(¥1,420/月),2 万档 15 个月、5 万档 39 个月回本[18]。C 档还有一个隐性优势:以 1.5 万元 Strix Halo 整机(月电费约 ¥22,8h/天口径)对照 Claude Max 20x,回本约 11 个月、对照百炼 27B(300M/月)约 25 个月(推算,口径同表 4-4)——统一内存低功耗使低价档位的回本弹性反而优于高价独显档。
二手路线进一步压缩回本窗口:双 RTX 3090(48GB 显存池)整机约 ¥10,000–14,000,是当前最便宜的 27B 甜点替代[103];以 ¥12,000 中值、月电费约 ¥60(推算,双卡均载约 500W×8h/天)计,对照 Claude Max 20x 订阅回本仅约 9 个月,对照百炼 27B 重度用量约 21 个月——几乎打平全新 A 档的一半。但其期望成本需计入矿卡/过保风险溢价(流通卡全已过保,2026 年二手卡整体涨价 10–25%),且 936GB/s 带宽上限使其无法升级到 FP8 与更长上下文,属于"用风险与升级空间换回本速度"的选项[103]。
把"回本月数 ≤24"作为可行线,满足条件的组合收敛为:重度 Agent 用户(≥300M token/月)+ 2 万元级硬件 + 对照物为旗舰 API 或 ≥¥700/月的高端订阅。其余组合的"回本"须由隐性价值重构:数据隐私与合规(受监管场景云端选项直接不可用,回本从第 0 天成立)、离线可用与业务连续性(不受模型 ID 退役、停服与宕机影响)、无 rate limit(批量任务的等待时间成本转为硬件利用率)、可微调性(Qwen3.8-27B 与 V4-Flash 均为开放权重,可 LoRA 微调,差异化能力是资产而非成本)、以及成本可预测性(硬件 CapEx 对冲 2026 年 API 集体涨价)[118]。按 3 年残值 40–50% 修正后,上表全部回本月数还可再打约 6–7 折(推算)。
需要标注三点局限:① 能力不完全对等——本地 27B ≠ Qwen3.8-Max/Claude 级质量,对高价参照系的回本月数隐含质量折让;② 284B-MoE 本地部署的实用性门槛在 10 万元档以下并不从容,D 档高配的回本数字以"愿意承担 4 卡运维"为前提;③ API 价格处于快速变动期,若行业涨价趋势延续,本地部署拐点将继续下移。更重要的是,内存涨价周期尚未见顶(行业判断 2027 年达峰[10]),硬件端与云端价格仍在相向运动——本章的回本窗口是一个仍在变化的快照,下一章将对其做十二个月推演。
5. 未来十二个月推演(2026-09 至 2027-08)
本章与前四章性质不同:此前所有结论建立在已发布模型、已实测硬件与已核实行情之上,本章则是面向未来十二个月的前瞻推演。推演方法分三层:① 以已发生事实为锚点(如 M5 Ultra 已发布、Qwen3.8-Flash-Next 已开源),此类判断置信度最高;② 官方口径或一手爆料(The Information、摩根大通、Gurman 等)如实标注来源,未经官方确认的爆料一律降级;③ 纯历史节奏外推与单一低可信来源只作方向性参考。全文置信度分四级:high(多源互证或官方已确认)、medium-high(单一权威来源加旁证互证)、medium(合理外推或官方自报)、exploratory(方向存在但证据薄弱),分级标准详见附录表 7-1。每条推演均附"对个人部署决策的含义",供第 6 章行动建议引用。
5.1 模型侧推演
5.1.1 发布节奏:三个关键时间窗
模型侧未来十二个月的确定性来自"已灰度、已预览、已承诺"三类信号。DeepSeek V4.1 正式版预计 2026 年 9–10 月落地(high):V4.1 Flash 已于 6 月灰度测试,The Information 报道其已向投资者承诺加快发布频率,7 月底与 8 月中旬的两次正式更新已验证提速兑现[121][122]。V4.5 或 R2 级推理专项落在 2026 Q4–2027 Q1(medium;R2 因多次推迟史,其独立存在性仅为 exploratory)[123]。DeepSeek V5 最可能落在 2027 年 Q2(medium 偏 exploratory):依据是 V3→V3.2 间隔 11 个月、V3.2→V4 间隔 5 个月的历史节奏,叠加 2026 年 6 月约 500 亿元融资后的算力扩张[122][124]。Qwen 一侧,8 月 26 日开源的 Qwen3.8-Flash-Next 已被官方明确为 Qwen4 架构的早期预览(125B 主干、6B 激活、51B n-gram 查表嵌入),参照 Qwen3-Next→Qwen3.5 约 5 个月的先导节奏与阿里"春节爆款"传统,Qwen4 完整家族大概率落在 2027 年 Q1 春节档(medium-high)[19][20]。其余玩家:GLM-5.5(摩根大通预测参数破 1T)与 MiniMax M3 Pro(2.7T,开源)预计在 2026 Q4 前落地(medium-high)[125][126];Kimi K4 预计 2027 H1 继续 scale(medium)[127];Gemma 5 跟随 Gemini 4 约 2027 Q1–Q2(medium-high)[35];Meta 旗舰则大概率保持闭源(high)[128]。
表 5-1 模型侧"时间—事件—置信度"推演表(2026-09 至 2027-08)
| 时间窗 | 推演事件 | 依据 | 置信度 |
|---|---|---|---|
| 2026-09/10 | DeepSeek V4.1 正式版(全模态补齐、Agent 工具链) | Flash 已灰度 + 提速承诺已兑现[121][122] | high |
| 2026 Q4 | GLM-5.5(>1T,MIT 开放权重);MiniMax M3 Pro(2.7T)开源 | 摩根大通预测;The Information 报道[125][126] | medium-high |
| 2026 Q4 | Qwen3.9 或 Qwen4 先导小尺寸落地 GDN+QSA 新架构 | Flash-Next 已开源 + 5 个月先导模式[19][20] | medium |
| 2026 Q4–2027 Q1 | DeepSeek V4.5 或 R2 级推理专项 | 提速承诺;R2 长期传闻且多次推迟[123] | medium(R2 exploratory) |
| 2027 Q1(春节档) | Qwen4 完整家族(Max 级 + 27B 级甜点档) | 官方架构预览 + 春节发布传统[19][20] | medium-high |
| 2027 Q1–Q2 | Gemma 5(≤35B,Apache 2.0);Kimi K4(继续 scale) | Gemma 年度节奏;K4 官方标语与 IPO 叙事[127][35] | medium-high / medium |
| 2027 Q2 | DeepSeek V5(1.5–2T 级、激活比 2–3%、记忆模块并入主干) | 大版本 8–12 个月间隔 + 融资后算力扩张[122][124] | medium 偏 exploratory |
| 全程 | Meta 旗舰保持闭源;Llama 中小杯"中段开放" | Muse Spark 先例与官方分层逻辑[128] | high |
| 全程 | 1M 上下文成 API 默认档;Agent 自治时长取代静态榜成核心营销 | 阿里定价表与各厂商基准构成[129] | high |
分析解读: 其一,时间窗高度集中:2026 Q4 与 2027 Q1 合计承载表中七成事件,春节档(2027 年 2 月前后)是 DeepSeek 与 Qwen 双重传统窗口,预计成为模型侧全年最强更新点。其二,置信度结构与事件性质强相关:high 项全部属于"已灰度/已预览/已官宣分层策略"的兑现型事件,而 V5、R2 等无官方信号的下一代旗舰只能给出 exploratory 级判断——读者应对所有指向 2027 H2 的模型预测保持折扣。其三,对个人的含义是:等待模型侧的边际收益集中在 2026 Q4–2027 Q1 这六个月,若当前需求已被 Qwen3.8-27B / V4-Flash 覆盖,等 Qwen4 甜点档(预计 2027 Q1)是唯一有明确时间锚的"等等"理由。
5.1.2 结构趋势:稀疏化加深与稠密固化共存
未来十二个月模型架构将沿三条已被 2026 年验证的轨道继续演进,且对个人部署均为净利好。其一,MoE 稀疏化加深与 ≤35B 稠密固化共存(high):2026 年旗舰已清一色 MoE,但 Qwen3.8-27B、Gemma 4 31B Dense 等 ≤35B 稠密型号同为年度爆款,三层格局(≥400B 超大 MoE / 100–300B 高稀疏 MoE / ≤35B 稠密)预计固化——稠密不会回潮到旗舰,但凭无路由坍塌、量化友好、框架成熟的优势长期统治端侧甜点档[34][35]。其二,激活参数占比继续下探,"非计算参数"兴起(high 方向,具体数值 medium):旗舰激活比从 V3 的 5.5% 降至 V4-Pro 的 3.1%、K3 的约 1.8%,Qwen 与 DeepSeek 同时走向"n-gram/条件记忆查表参数卸载至廉价 DRAM/SSD"的路线,预计 2027 年旗舰激活比普遍落入 2–3% 区间[19][130][33]。
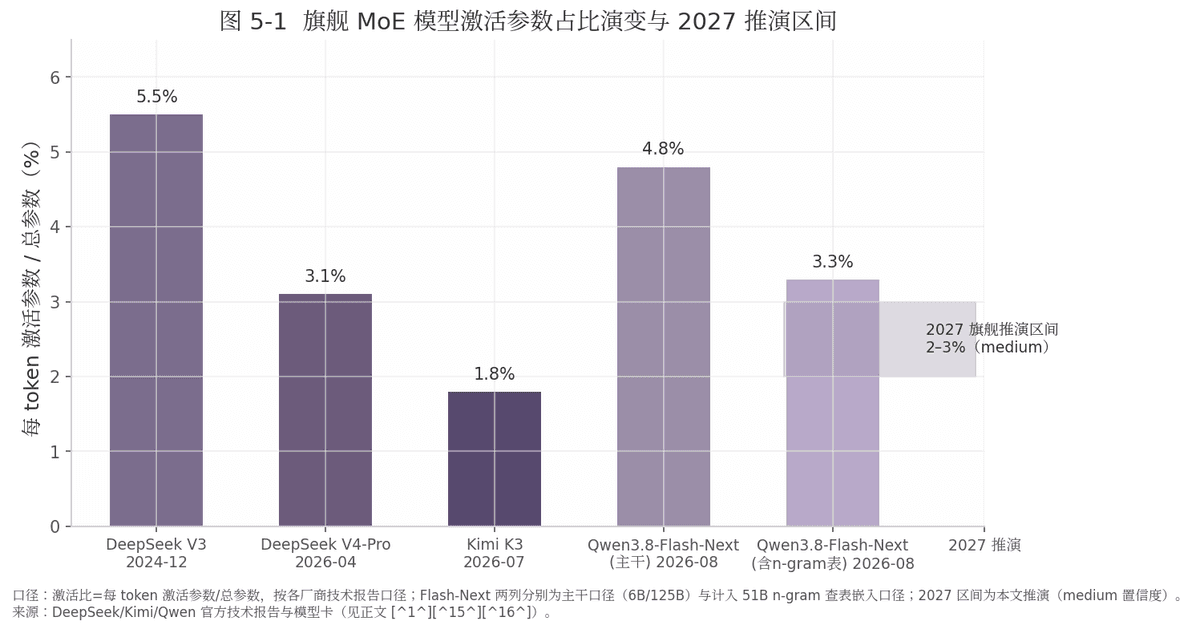
激活比下降的直接后果是 decode 带宽需求与内存容量解耦:125–300B 级高稀疏模型叠加 FP4/2–3 bit 动态量化与查表参数卸载,使"128GB 统一内存跑准旗舰"在 2027 年从演示变为常态配置(推算自 Flash-Next FP8 约 168GB 已逼近该区间的事实)[19][33]。其三,Agent/编程成为后训练主战场(high):预训练 scaling 收益递减叠加 OpenAI/Anthropic/Google 联手限制 CoT 蒸馏,RL 与 Agent 环境成为唯一差异化战场,DeepSeek 已组建对标 Claude Code 的 Harness 团队,新旗舰发布将以"自治任务时长"取代 MMLU 类静态榜为核心营销指标[129][131]。对个人的含义:评估下一代模型的本地价值,应优先看其 Agent 基准与是否自带投机解码模块,而非账面参数。
5.1.3 风险:开源进入"权重照发、授权收紧、顶配裁剪"常态
本章最大的下行风险不在能力而在授权。综合 Meta 旗舰闭源、Qwen 转向自定义许可(qwen3.8-max、Qwen Community License 1.0)、Kimi K3 采用修改版 MIT、"开源甜点区上移"等信号,未来十二个月"权重照发、授权收紧、顶配裁剪"成为新常态的概率约 70%(方向判断 high,概率值为推算)[128][24][25]。反向约束同样真实:OpenRouter 开源 token 份额已从 2026 年 1 月的 34% 升至 6 月的 65%,"不开源=出局"的商业压力使 DeepSeek、GLM、MiniMax 完全闭源化的概率仅约 15%,阿里约 30%(观察指标为其 MaaS 收入占比是否超过 IaaS)[27]。同时,2T+ 级权重将延续"名义开源、实际不可部署"——K3 需 ≥1.5TB 显存的先例表明,"全球最强开源模型"与"个人可部署最强模型"的脱钩会继续加深[25]。对个人的含义:当前 Qwen3.8-27B(Apache 2.0)与 V4-Flash(MIT)的组合属于历史甜点期;权重一旦下载即不受后续授权变化追溯影响,及时下载并归档关键权重与量化版本,本身就是成本为零的风险对冲。
5.2 硬件与软件侧推演
5.2.1 硬件:统一内存跃进与消费级 GPU 空窗并存
硬件侧的格局异常清晰:Apple 的 M5 Ultra(512GB 统一内存、1.2TB/s 带宽)已于 2026-08-25 发布,9 月 22 日发售、512GB 配置 10 月末出货,成为窗口内唯一官方渠道可购的"单机 FP16 70B / 400B+ 量化"桌面设备,并首次官方支持四机 RDMA 分布式推理(约 3 倍单机性能)[21];按约 17 个月的 Ultra 迭代节奏,下一代 Ultra 预计 2028 年才出现,窗口内无替代者(medium-high)[132]。NVIDIA 消费级则进入空窗:RTX 50 SUPER 因 3GB GDDR7 颗粒成本三倍于 2GB 而被无限期搁置(high),RTX 60 系(Rubin 架构)最早 2027 H2 发布,本窗口内大概率只见纸面信息(medium-high)[22][133][134]。AMD 以 Gorgon Halo(2026 Q4,带宽约 273GB/s,无质变,high)过渡,真正的换代 Medusa Halo(384-bit LPDDR6,理论带宽 455–614GB/s)预计 2027 年发布、窗口尾端难以买到(medium)[135][136]。国产侧,昇腾 950PR 放量与 950DT(2026 Q4)落地确定性高(high),但消费级大显存国产卡仍然缺位[137]。
表 5-2 硬件/软件侧"时间—事件—置信度"推演表(2026-09 至 2027-08)
| 时间窗 | 推演事件 | 依据 | 置信度 |
|---|---|---|---|
| 2026-09/10 | Mac Studio M5 Ultra 发售、512GB 配置出货 | 苹果官方已定[21] | high |
| 2026 Q4 | Gorgon Halo 上市(~273GB/s);昇腾 950DT 发布;LPDDR6 首批旗舰手机 | AMD 已介绍;华为路线图;海力士量产[135][137][138] | high / medium / high |
| 2026 Q4 | llama.cpp 多批量投机解码补齐、Ollama 默认开启 | MTP 已合并、迭代节奏外推[139] | medium |
| 2026 Q4–2027 H1 | NVIDIA 消费级无新卡;5090 改装 96/128GB 灰产卡继续流通 | SUPER 搁置确认;改装卡现货先例[22][140] | high / medium |
| 2027 H1 | 开源旗舰普遍附带官方 FP4 checkpoint;Transformers v5.0 集成 ModelOpt 路径 | ModelOpt 已成 vLLM/SGLang 首选后端[141] | high / medium-high |
| 2027 H1 | Apple M7 标准版(~240GB/s,不触及 Ultra 档) | Gurman 爆料[132] | medium |
| 2027 H2(窗口尾) | RTX 60 系临近发布但难买到;Medusa Halo 或官宣未量产 | 多源爆料互证[134][136] | medium-high / medium |
| 贯穿窗口 | DRAM/显存涨价不缓解,2027 年达峰 | Intel/三星/宇瞻/TrendForce 一致指向 2028 缓解[23][142][143] | high |
| 贯穿窗口 | FP4+投机解码成推理栈标配;消费级单机实用上下文推进至 256–512K,1M 需 512GB 级设备 | KV 压缩实测与引擎路线图[139][141][7] | high / medium |
分析解读: 三点含义突出。其一,供给断层是结构性的:NVIDIA 空窗期(2026 全年至 2027 H2)恰好覆盖整个推演窗口,期间大显存消费级需求只能由 48GB 魔改卡、72GB RTX PRO 5000 与统一内存设备承接,改装灰产卡与官方高价卡并行的格局不会改变[22][140]。其二,带宽竞赛的主战场移至统一内存:M5 Ultra 的 1.2TB/s 与 Medusa Halo 传出的 455–614GB/s 标志着"内存带宽×容量"取代 TOPS 成为本地推理硬件的新货币,但两者存在明显时间差——M5 Ultra 现货在 2026-10,Medusa Halo 量产在 2027 之后,窗口内 Apple 实质上独占大内存甜点档[21][136]。其三,软件红利(FP4、投机解码)全部落在存量硬件上兑现,意味着已购硬件在窗口内会持续"免费变快",而新购硬件不会更便宜。
5.2.2 成本环境:内存涨价贯穿窗口期
成本侧多源一致指向悲观结论:Intel CEO 称 DRAM 短缺至少持续两年、2028 年才缓解;宇瞻警告 2027 年通用 DRAM 供应量或骤降 70%;TrendForce 预计 2027 年 HBM/DRAM 合约价继续大涨——内存/显存涨价将贯穿整个推演窗口并于 2027 年达峰,本地部署在窗口内不会变得更便宜(high)[23][142][143]。消费级 DDR5 零售虽在 2026 年 3 月出现首次回调,但颗粒端坚挺,属结构性分化而非周期见顶。对个人的含义是采购逻辑的反转:在涨价周期内"等等党"失效,早买等于锁定成本;叠加第 4 章所述大显存卡"三年零折旧"的反常残值曲线,窗口内购置 A/B 档 GPU 的持有风险显著低于常态年份(推算)。
5.2.3 软件:FP4 与投机解码标配化,1M 上下文登上 512GB 级设备
软件侧两项红利将在 2026 年内完成标配化(high):NVFP4 已成为 vLLM/SGLang 一等量化后端并将于 Q4 接入 Transformers v5.0,窗口内发布的开源旗舰预计普遍附带官方 FP4 checkpoint[141];投机解码自 2026 年上半年起已是 llama.cpp、MLX、vLLM/SGLang 的默认可用特性,单流普遍 1.7–2.6 倍加速[139]。长上下文方面,CSA/HCA 类架构已把 1M 上下文的 KV cache 压至个位数 GB,284B 级 MoE + 1M 上下文在 128GB 统一内存设备上已被多次演示(2-bit 权重约 81–91GB + KV 约 3–10GB),预计十二个月内从研究级配置转为 llama.cpp/vLLM 主流支持的常规配置(high);而真正的 1M 实用化(速度可接受)仍属 512GB 级统一内存设备或多机集群(medium)[7][144]。对个人的含义:软件侧的等待价值趋近于零——红利会自动落到现有设备上;唯一需要主动跟进的是选择自带投机解码模块与官方 FP4 权重的新模型。
5.3 情景推演
综合模型、硬件、成本三条线,构建三情景并给出个人部署策略含义(概率为推算值)。
基准情景(概率约 60%):按当前节奏演进。 模型侧 Qwen4 于 2027 Q1、V5 于 2027 Q2 落地且授权维持现状框架;硬件侧 M5 Ultra 放量、NVIDIA 空窗;内存 2027 年达峰不缓解。策略含义:按需采购、不等硬件。27B 甜点档(24GB N 卡整机)随时可买;瞄准 284B 级 MoE 的用户,M5 Ultra 512GB(10 月末出货)与 128GB 统一内存小主机是窗口内的确定性选项;若需求可被现有模型覆盖,唯一值得的等待是 2027 Q1 的 Qwen4 甜点档。
乐观情景(概率约 20%):内存提前缓解或出现超预期强开源。 触发信号:LPDDR6 放量快于预期、2027 H1 DRAM 合约价涨幅明显收窄,或 DeepSeek V5/Qwen4 甜点档以宽松许可提前发布且激活比落入 2% 以下。策略含义:观望窗口可延长至 2027 Q1,重点等待 Qwen4 27B 级型号与 Medusa Halo 官宣;已购 128GB 级统一内存设备的用户将直接受益于激活比下降,无需追加投资。
悲观情景(概率约 20%):授权收紧叠加内存继续超预期上涨。 触发信号:阿里 MaaS 收入占比越过 IaaS、Qwen4 甜点档改用自定义许可,中国前沿模型发布管控细则落地导致旗舰权重延迟开源,DRAM 供给收缩超预期推高整机价格。策略含义:立即采购并归档——趁当前 Apache 2.0 / MIT 权重与存量硬件仍在,下载归档关键模型的多档量化版本;硬件上优先选择残值坚挺的大显存 N 卡而非内存焊死的统一内存小主机,以对冲后续涨价与换代风险。
三情景的交集结论值得强调:无论何种情景,"已下载的权重 + 已购的硬件"都是贬值最慢的资产,而等待在模型侧只有 2027 Q1 一个明确锚点、在硬件侧没有锚点——这为第 6 章的行动建议奠定了基调。
6. 结论与行动建议
前五章分别在模型、软件、硬件、成本与推演五个维度建立了证据链,本章将其收束为对四个问题的直接回答:硬件门槛是什么、值不值得买、买什么、现在买还是等。结论先行:个人本地部署的能力门槛已降至历史低位,成本门槛却处于涨价周期高位;是否购买不取决于"硬件好不好",而取决于用量画像与参照系;等待在硬件侧没有收益,在模型侧只有 2027 Q1 一个锚点。
6.1 核心结论
6.1.1 两个甜点层确立:27B 稠密 + 24GB 单卡;300B 级 MoE + 128GB 统一内存
截至 2026 年 8 月,个人部署的硬件门槛收敛为两个由物理账目锁定的稳定甜点层。甜点一:27B 稠密 + 24GB N 卡。Qwen3.8-27B 的 Q4 权重约 17GB、262K 上下文 KV cache 约 16GiB,恰好落入 24GB 显存;开启内置 MTP 投机解码后 RTX 3090/4090 实测 40-65 tok/s、RTX 5090 达 133-206 tok/s,整机投入约 ¥21,000-45,000[8][5][9]。甜点二:300B 级高稀疏 MoE + 128GB 统一内存。DeepSeek-V4-Flash(284B 总参/13B 激活)经动态量化压至 91-104GB 后,128GB 统一内存设备实测 20-35 tok/s,把前沿级能力带入 ¥14,000-35,000 价位[11][77][12]。中间的 70B 稠密档(需 48GB+ 显存且带宽受限)被两极夹击而空洞化:同价位下要么不如 27B 档快,要么不如 300B MoE 档强,厂商供给侧亦同步向两极收敛,该档已从推荐清单中实质消失[34]。
6.1.2 七项跨维度洞察汇总
以下七项洞察均来自两个以上维度的交叉证据,每项附其对采购决策的直接含义:
6.2 分人群行动建议
6.2.1 按用量画像对号入座:轻度用 API、中度自建或订阅、重度按场景上硬件
沿用第 4 章的用量画像(轻度 5M、编程中度 30M-100M、重度 Agent 300M+ token/月)与 A/B/C/D 分档命名[119],分人群建议汇总如下:
表 6-1 分人群行动建议表(2026-08 行情)
| 人群 | 推荐方案 | 预算 | 预期体验 | 回本逻辑 |
|---|---|---|---|---|
| 轻度用户(≤5M token/月) | 继续用 API,首选 DeepSeek 官方直连,低谷时段与缓存命中再降 98%[15][16] | ¥0(月账单 ¥2 级) | 旗舰能力即时可用,无运维 | 任何硬件月电费即超云端账单,永不回本,不买即最优 |
| 编程中度用户(30M-100M token/月) | 首选 A 档自建(RTX 4090 24GB 整机);预算受限选二手双 3090 或维持 ¥142/月级订阅[92][103][18] | ¥21,000-26,000;二手路线 ¥10,000-14,000 | 27B Q4+MTP 40-65 tok/s、32-64K 上下文舒适[8][5] | 对照同模型百炼 API 不回本;对照旗舰 API 需 26-108 个月——纯经济性不成立,为隐私、无 rate limit 与体验买单 |
| 重度 Agent 用户(300M+ token/月) | B 档(27B 满血长上下文)或 C 档(128GB 统一内存跑 284B 量化)起步,按场景上 D 档 | B 档 ¥28,000-38,000;C 档 ¥14,000-16,000;D 档 ¥45,000-150,000 | B 档 262K 全开;C 档 20-35 tok/s、64-128K;D 档 43-367 tok/s[12][13][86] | 对照旗舰 API/托管价 8-13 个月回本;对照 Claude Max 20x 订阅 15 个月(2 万档)/约 11 个月(C 档,推算)[18] |
| 隐私敏感/合规用户 | 不看回本表,直接按数据敏感度选档:27B 够用选 A/B 档,须前沿能力选 C/D 档 | 同上 | 同上 | 云端选项在合规约束下直接不可用,回本从第 0 天成立 |
分析解读: 其一,用量是唯一的一阶变量:表 4-4 的回本矩阵中,同一档硬件在 5M 与 300M 用量下的结论完全相反,轻度用户买硬件在本轮 API 地板价下是纯亏损,重度用户不买硬件则是把订阅费持续交给云端。其二,C 档是被低估的"回本黑马":1.4-1.6 万元的国行 Strix Halo 整机(月电费约 ¥22)因功耗极低,对照高端订阅的回本速度反而优于高价独显档,但其 20-35 tok/s 的速度只适合批处理式 Agent 流水线,不适合交互式编程。其三,二手双 3090 是唯一的"例外解":约 ¥12,000 的对照 Claude Max 20x 回本仅约 9 个月,但需自担过保与矿卡风险,且 48GB 显存池锁死了升级空间[103]。
6.2.2 现在买还是等:等待在硬件侧没有锚点
对"再等等"的最直接反驳来自成本侧:内存/显存涨价将贯穿整个推演窗口并于 2027 年才达峰、2028 年缓解,NVIDIA 消费级新卡空窗至 2027 H2[23][142][143][22]。与此同时,FP4 与投机解码等软件红利全部免费落在存量硬件上——已购设备会持续"变快",而新购设备不会更便宜。模型侧唯一有明确时间锚的等待理由是 2027 Q1 的 Qwen4 甜点档(medium-high 置信度)[19][20]。因此行动准则收敛为一句:需求已被 Qwen3.8-27B 或 V4-Flash 覆盖的,现在买;需求尚未明确的,先把权重下载归档,等 2027 Q1 再决策。无论何种情景,"已下载的权重 + 已购的硬件"都是这一轮周期中贬值最慢的资产。
7. 附录:研究方法、置信度与冲突处理
7.1 研究方法与来源分层
7.1.1 十二维度并行调研、交叉验证四层分级、针对性验证流程
本报告采用多代理并行调研方法:十二个维度子代理分别覆盖模型规格、实测性能、部署底线、GPU 行情、统一内存平台、压缩技术、成本电费、API 定价、模型与硬件路线推演等方向,各自独立完成检索,并以"论断/来源/URL/日期/原文摘录/置信度"六字段格式记录证据。此后由交叉验证流程汇总比对,仅当结论获得两个及以上独立来源或代理一致支持时才列入高置信度清单,本轮共形成十条共识结论。针对调研中暴露的关键分歧(RTX 5090 价格口径),另启动一轮针对性验证,以逐月价格追踪与多渠道行情互证完成裁决[10][145]。
来源按可信度分层:T1 层为官方文档、技术报告与权威机构一手材料(如 vLLM 官方 Recipes、Unsloth 官方文档、Apple 官方新闻稿[11][21]),优先采信;T2 层为主流科技媒体与厂商官方博客(快科技、IT之家、MacRumors 等[10]),用于行情与事件交叉印证;内容农场与匿名来源不予采用。全部结论按下表四层置信度分级标注,并在正文中保留相应限定语。
表 7-1 置信度四层分级说明表
| 等级 | 判定标准 | 典型示例 | 报告中的使用方式 |
|---|---|---|---|
| 高(high) | ≥2 个独立来源或代理一致,含一手实测 | Qwen3.8-27B 显存数学;5090 八月行情[10][145] | 直接作为论证依据 |
| 中高(medium-high) | 单一权威来源加旁证互证 | 1M 上下文 KV cache 压缩量级 | 可用,注明统计口径 |
| 中(medium) | 单一权威来源、官方自报或带宽推算 | DSpark 加速比;M5 Ultra 推算速度 | 可用但保留限定语 |
| 探索(exploratory) | 历史节奏推演,无直接证据 | RTX 60 系 2027H2 发布窗口 | 仅作情景参考,不作决策依据 |
从分布看,本轮调研的高置信度结论(十条)集中于"可实测"领域——显存占用、实测速度与当期行情;中置信度项(五项)集中于两类:官方自报数据(缺乏第三方复测)与基于历史节奏的未来推演(受供应链变量扰动)。这一分布的含义是:报告对现状描述的可信度显著高于对十二个月推演的可信度,读者宜将推演内容视为情景分析而非确定性预测;分级机制的价值正在于把两类论断在文本层面强制隔离。
7.2 已解决的冲突与遗留不确定性
7.2.1 三处口径冲突的裁决
RTX 5090 价格属时间性冲突而非事实矛盾:早期来源的约 $2,000 为官方建议零售价(MSRP),2026 年 1 月起 GDDR7 供应危机推动价格逐月上行,至 8 月美国街价达 $4,100-4,900、较 MSRP 溢价约 135%-145%[10],国内全新非公版成交价为 ¥27,500-35,000[145]。报告统一采用 2026 年 8 月时价,历史价格仅用于计算涨幅。
DeepSeek-V4-Flash 总参数量的 284B 与 304.18B 亦非矛盾而是口径差:284B 为技术报告的纯架构参数,304,180,418,494(约 304B)为 Hugging Face safetensors 元数据实数,差额来自内置的 DSpark 投机解码草稿模块[3][30]。报告两口径并存使用,逐处注明所指。
"128GB 设备装不下 V4-Flash" 的分歧源于"原生精度"与"量化压缩"两档混用:原生 FP4 权重 155.4 GiB 确实超出单机 128GB[31];而 Unsloth 动态量化甜区 91-104GB(最小 82.5GB)可在 128GB Mac 上运行(IQ2 档实测 27-34 tok/s),代价是质量有损[11][76]。报告统一按两档分别表述,不再使用笼统的"装得下/装不下"。
7.2.2 遗留不确定性
三项遗留不确定性已在正文逐条标注。其一,M5 Ultra 实测缺失:其运行 V4-Flash 约 55-75 tok/s 为带宽推算,类推自 M3 Ultra 上 22B 激活 MoE 的实测基线外推至 1.2TB/s[84];该机型 2026 年 8 月 25 日才发布,截至调研截止日(8 月 29 日)尚无第三方实测[21]。其二,DSpark 加速比为官方自报:吞吐 +51%、单用户再提速 60-85% 均无第三方复测,且该数字是相对已加速的 MTP-1 基线的增量,而非相对朴素自回归解码[37]。其三,类推与换算数据:部分 tok/s 数字类推自同量级模型实测,正文保留"推算"字样;M3 Ultra 192GB 国行现价系由海外报价 $5,499-6,999 换算推算[101]。所有十二个月推演均已标注 high/medium/exploratory 置信度,便于读者按风险偏好取用。
参考文献
[1] Kingy AI:Qwen3.8-27B 规格复核与本地硬件分析[EB/OL]. 2026-08-14. https://kingy.ai/blog/qwen3-8-27b-specs-benchmarks-local-hardware/
[2] CSDN 深度评测:Qwen3.8-27B 权重与许可核实[EB/OL]. 2026-08-16. https://deepseek.csdn.net/6a8197e210ee7a33f29bc084.html
[3] mer.vin:DeepSeek-V4-Flash 304B 元数据读取与 config.json 核对[EB/OL]. 2026-08-05. https://mer.vin/news/deepseek-v4-flash-a-304b-model-on-one-amd-mi300x-gpu/
[4] vLLM 官方 Recipes:DeepSeek-V4-Flash 部署配方[EB/OL]. 2026-08-27. https://recipes.vllm.ai/deepseek-ai/DeepSeek-V4-Flash
[5] GitHub:llama.cpp PR #22673(MTP 投机解码合并)[EB/OL]. 2026-05-16. https://github.com/ggml-org/llama.cpp/pull/22673
[6] DataLearner:Qwen3.8-27B 本地部署量化指南(Q4 质量拐点)[EB/OL]. 2026-08-19. https://www.datalearner.com/blog/qwen3-8-27b-local-deployment-quantization-guide
[7] GitHub ForceInjection:从 MLA 到 CSA+HCA 的 KV 逐层推导(引 vLLM 官方博客)[EB/OL]. 2026-05-08. https://github.com/ForceInjection/AI-fundamentals/blob/main/09_inference_system/vllm/module_analysis/deepseek_attention_evolution_mla_to_csa_hca.md
[8] 什么值得买(smzdm):Qwen3.8-27B 社区实测汇总(24G 档 Q4 稳定 40-53 tok/s、5090/Mac/多卡配速表)[EB/OL]. 2026-08-19/23. https://post.smzdm.com/p/am9xwm7z
[9] 搜狐/至顶 AI 实验室转引 SGLang 团队首日测试(5090 NVFP4+DSpark 206.1 tok/s、关投机约 60;DGX Spark 38.28 tok/s)[EB/OL]. 2026-08-20. https://www.sohu.com(Qwen3.8-27B SGLang 首日测试时间线)
[10] 快科技:RTX 5090 美国实售 $4,699、较 MSRP 溢价 135%[EB/OL]. 2026-08-17. https://news.mydrivers.com/1/1144/1144383.htm
[11] Unsloth 官方文档:DeepSeek-V4 本地运行指南(量化梯度与 KLD)[EB/OL]. 2026-08-26. https://unsloth.ai/docs/zh/mo-xing/deepseek-v4
[12] Lucebox 技术博客:Strix Halo 跑 V4-Flash(自研 ROCm 栈 + DSpark 最高 32 tok/s;公开榜 HipFire 18.99 / DwarfStar 15.6 tok/s)[EB/OL]. 2026-07-18/20. https://www.lucebox.com/blog/deepseek-v4-strix-halo
[13] GitHub yhfgyyf/vllm-deepseek-v4-sm89:4× RTX 4090 实测(原生 ~82 tok/s;DSpark 8K 366.95 / 128K 219 tok/s;768K 可跑完)[EB/OL]. 2026-08-22/26. https://github.com/yhfgyyf/vllm-deepseek-v4-sm89
[14] GitHub Gist(AlexsJones):64GB Strix Halo + SSD 专家流式加载实测("6 of 256 experts fire per token"、~1.9 tok/s)[EB/OL]. 2026-07-05. https://gist.github.com/AlexsJones/9b43e7b8f3682679d17f255a3ca0d9d3
[15] FelloAI 定价指南(引 DeepSeek 官方定价页):V4-Flash $0.14/$0.28、缓存命中 $0.0028[EB/OL]. 2026-08-22. https://felloai.com/deepseek-pricing
[16] 新浪财经/微博公告转述:DeepSeek 峰谷计价(工作日高峰 2×、低谷半价、周末全天低谷;人民币高峰 3/9 元、低谷 1.5/4.5 元)[EB/OL]. 2026-08-24. https://k.sina.com.cn/article_7880068204
[17] 阿里云官方帮助文档:qwen3.8-27b 输入 ¥3/输出 ¥12/缓存命中 ¥0.6 每百万 token[EB/OL]. 2026-08-27. https://help.aliyun.com/zh/model-studio/qwen3-8-27b
[18] morphllm/screenapp:Claude Pro 100、Max 20x $200[EB/OL]. 2026-08-21. https://morphllm.com/claude-code-pricing
[19] ModelScope:Qwen3.8-Flash-Next 官方模型卡(Qwen4 架构早期预览,125B/6B+51B n-gram,GDN+QSA)[EB/OL]. 2026-08-26. https://modelscope.cn/models/Qwen/Qwen3.8-Flash-Next
[20] CSDN:阿里云峰会复盘(预测 2027 年 Q1 发布 Qwen4.0)[EB/OL]. 2026-05-20. https://blog.csdn.net/xyghehehehe/article/details/161263637
[21] Apple 中国官网新闻稿:Mac Studio M5 Max / M5 Ultra 发布(512GB 统一内存、1.2TB/s、四机 RDMA 集群、9 月 22 日发售)[EB/OL]. 2026-08-25. https://www.apple.com.cn/newsroom/2026/08/apple-introduces-mac-studio-with-m5-max-and-m5-ultra/
[22] 博板堂 via C114:NVIDIA 通知 AIC 无限期搁置 RTX 50 SUPER 系列[EB/OL]. 2026-01-13. https://c114.net.cn/industry/50851.html
[23] EET-China:Intel CEO 陈立武称内存短缺至少持续两年、2028 年才缓解[EB/OL]. 2026-02. https://eet-china.com/mp/a472695.html
[24] 稀土掘金:开源甜点区上移——"2023 年 72B 是开源旗舰,2026 年只有 7B-14B 还在宽松开源"[EB/OL]. 2026-06-06. https://juejin.cn/post/7648082945085587502
[25] CSDN:Qwen3.8-Max 首个开放权重 Max 级但自定义许可+功能裁剪("3T 级旗舰授权收紧成新常态")[EB/OL]. 2026-08-14. https://deepseek.csdn.net/6a7ec03b662f9a54cb9ca752.html
[26] 中关村在线:DDR5/SSD 消费级涨价(16GB DDR5 450→1,800 元)[EB/OL]. 2026-07-08. https://diy.zol.com.cn/1212/12120106.html
[27] 界面新闻:OpenRouter 开源 token 份额从 34% 飙至 65%[EB/OL]. 2026-07-24. https://www.jiemian.com/article/14819353.html
[28] OrcaRouter:Qwen3.8-27B 基准汇总(含 harness 脚注)[EB/OL]. 2026-08-17. https://www.orcarouter.ai/blog/qwen-3-8-27b-benchmarks
[29] wiselychen:Qwen3.8-27B KV cache 测算(262K 全开 16GiB)[EB/OL]. 2026-08-15. https://ai-coding.wiselychen.com/qwen-3-8-27b-open-weights-local-security/
[30] NVIDIA NIM 模型卡:DeepSeek-V4-Flash-0731[EB/OL]. 2026-08-25. https://build.nvidia.com/deepseek-ai/deepseek-v4-flash-0731/modelcard
[31] 51CTO:DeepSeek-V4-Flash-0731 权重 155.4 GiB 实测求和[EB/OL]. 2026-08-07. https://www.51cto.com/article/852206.html
[32] 七牛云:DeepSeek V3/R1 部署成本分析(671B/8 卡 H100/120 万元级)[EB/OL]. 2025-02. https://news.qiniu.com/archives/post-1778464651571-0
[33] 36氪:Kimi K3 开源但需 1.5TB 显存、64 卡超节点[EB/OL]. 2026-07-22. https://m.36kr.com/p/3906759052907910
[34] 腾讯云开发者社区:2026 旗舰 MoE 化与稠密分层格局观察[EB/OL]. 2026-06-30. https://developer.cloud.tencent.com/article/2700692
[35] 阿里云开发者社区:Gemma 4 系列开源且许可证放宽至 Apache 2.0[EB/OL]. 2026-04-08. https://developer.aliyun.com/article/1724313
[36] wiselychen:llama.cpp MTP 合并后 27B 单流 1.7-2.6× 实测汇总[EB/OL]. 2026-05. https://ai-coding.wiselychen.com/llama-cpp-mtp-merged-local-llm-2x-speedup/
[37] ModelScope 社区:DSpark 官方公告(vs MTP-1 +60-85%、吞吐 +51%)[EB/OL]. 2026-07-01. https://modelscope.csdn.net/6a447f72662f9a54cb8726c1.html
[38] 掘金(GPUStack):8×H20 生产实测 DeepSeek-V4-Flash + DSpark 600+ TPS[EB/OL]. 2026-08-06. https://juejin.cn/post/7670540811352834086
[39] Contra Collective:mlx-lm 0.21 Apple Silicon 投机解码基准(70B 45→95+ tok/s)[EB/OL]. 2026-06-11. https://contracollective.com/blog/mlx-lm-speculative-decoding-apple-silicon-2026
[40] arXiv 2601.09527:消费级 Blackwell NVFP4 实测(吞吐 +1.6×、能耗 -41%)[EB/OL]. 2026-01. https://arxiv.org/abs/2601.09527
[41] 搜狐:2026 DeepSeek V4 架构复盘(KV cache 为 V3.2 的 7-10%)[EB/OL]. 2026-06-05. https://m.sohu.com/a/1032496266_121124377
[42] CSDN:llama.cpp 长上下文 KV 量化实测(256K KV -71%)[EB/OL]. 2026-04-19. https://blog.csdn.net/w_jm/article/details/160299666
[43] ComputingForGeeks:Ryzen AI Max+ 395 迷你主机比价(Framework $1,999→$3,449)[EB/OL]. 2026-08-11. https://computingforgeeks.com/ryzen-ai-max-395-mini-pc-comparison/
[44] 中关村在线:2026 Q1 DRAM 合约价同比 +92%、涨价周期分析[EB/OL]. 2026-06-20. https://diy.zol.com.cn/1201/12017832.html
[45] 网易/cnBeta:RTX PRO 6000 官方价上调至 $16,000[EB/OL]. 2026-08-12. https://www.163.com/dy/article/L45IGME70511BLFD.html
[46] zenn.dev/toki_mwc:RTX 5090 + llama.cpp UD-Q4_K_XL 262K 一手实测(63.7-66.4 t/s;真实长文 30.4 t/s;262K prefill 4分27秒;MTP 与 262K 不可兼得;VRAM 核算)[EB/OL]. 2026-08-19. https://zenn.dev/toki_mwc(Qwen3.8-27B 5090 262K 实测)
[47] SGLang 官方 cookbook:Qwen3.8-27B(64 层 = 16×(3 GDN + 1 Gated Attention),GQA 24Q/4KV)[EB/OL]. 2026-08-14. https://docs.sglang.io/cookbook/autoregressive/Qwen/Qwen3.8-27B
[48] Qwen 官方 FP8 量化版 Qwen3.8-27B-FP8(block-128 细粒度,性能近无损,HF 镜像)[EB/OL]. 2026-08-14. https://ai.gitcode.com/hf_mirrors/Qwen/Qwen3.8-27B-FP8
[49] 搜狐:通义千问官方致谢 Unsloth;1-bit 版 8GB 内存可跑、保留约 77% 能力[EB/OL]. 2026-08-20. https://www.sohu.com/a/1065372395_211762
[50] 阿里云开发者:GB10(DGX Spark)Qwen3.8-27B 测速报告(Q8_0 vs Q4_K_M PPL 相对损失约 0.3%;单流天花板约 23 tok/s)[EB/OL]. 2026-08-17. https://developer.aliyun.com(Qwen3.8-27B GB10 测速报告)
[51] laeka.org:Quantization in 2026(2-bit 为质量悬崖、基准损失 10-20%,4-bit 为生产下限)[EB/OL]. 2026-03-21. https://laeka.org/publications/quantization-in-2026-gguf-gptq-awq-what-actually-works/
[52] EET-China/掘金:Unsloth NVFP4 版(约 23.4GB,比 BF16 快约 1.5 倍;SGLang 上 RTX 5090 decode 超 200 tok/s)[EB/OL]. 2026-08-15. https://www.eet-china.com/mp/a517763.html
[53] 什么值得买(smzdm):Mac 实测汇总(M4 Max 128G 63.1→42→11.3 tok/s @31K 断崖;M4 Pro 约 15 tok/s、32K TTFT 97-113s;M4 32G 5-6 tok/s;M4 mini 3.7 tok/s)[EB/OL]. 2026-08-14. https://post.smzdm.com/p/arzpv907
[54] PierpaoloPernici gist:vLLM 0.27.1 vs NInfer benchmark(5090 NVFP4+MTP3,decode 随上下文 85.2→11.3 tok/s @32K)[EB/OL]. 2026-08-26. https://gist.github.com/PierpaoloPernici
[55] GitHub julianmb/q38rocm:Strix Halo 深度优化一手实测(stock 12.27 → ROCmFP4+MTP 30.56-36.04 tok/s;temp 0.8 接受率约 25%)[EB/OL]. 2026-08-22. https://github.com/julianmb/q38rocm
[56] Kubesimplify:DGX Spark 一手实测(llama.cpp UD-Q4_K_XL decode 11.6 t/s;Ollama+MTP 26.5 t/s;单流天花板约 23 t/s 带宽口径;100K TTFT 约 90 秒)[EB/OL]. 2026-08-17. https://blog.kubesimplify.com(DGX Spark Qwen3.8-27B 实测)
[57] AMD 官方博客:Ryzen AI Max+ 395 最高 24.5 tok/s、Radeon AI PRO R9700 最高 51.8 tok/s(Day-0)[EB/OL]. 2026-08-14. https://amd.com(Qwen3.8-27B Day-0 支持公告)
[58] jdon:Qwen3.8-27B 本地部署实测(单卡 3090 Q4_K_M 31→41.3 tok/s;GGUF 七档量化 benchmark 跨度 2.9pp)[EB/OL]. 2026-08-17. https://www.jdon.com(Qwen3.8-27B 本地部署实测)
[59] llm-speed.com:Qwen3.6-27B 签名跑分(类推;4090 24G Q4 decode 44 tok/s,5090 74 tok/s)[EB/OL]. 2026-07-03. https://llm-speed.com(Qwen3.6-27B 跑分博客)
[60] mornai.cn:统一协议测试(RTX 5090 基础约 74、开 MTP 约 133、代码场景约 167 tok/s)[EB/OL]. 2026-08-21. https://mornai.cn(Qwen3.8-27B 统一协议测速)
[61] 腾讯云开发者社区:双 3090 部署实测(基础解码约 63 tok/s;DSpark 代码/JSON 170-210 tok/s)[EB/OL]. 2026-08-18. https://cloud.tencent.com/developer/article/2728549
[62] 今日头条·智域新知:2×4090 FP8+MTP3 上下文-速度实测(59.5@32K、40@64K、26@128K)[EB/OL]. 2026-08-23. https://www.toutiao.com(双 4090 Qwen3.8-27B 实测)
[63] helix.ml:RTX PRO 6000 Blackwell 生产环境调优(中位 149.8→167.8 tok/s,最佳代码格子 332)[EB/OL]. 2026-08-22. https://helix.ml(PRO 6000 Qwen3.8-27B 调优博客)
[64] 什么值得买/willitrunai:RTX 3060 12G 跑 27B Q4_K_M 需部分 offload,速度受损[EB/OL]. 2026-04. https://post.smzdm.com/p/a03ro390
[65] ModelScope 长文一手实测(4090:Q4+q4 KV+MTP3,192K 上下文 22.6GB、59.52 tok/s)[EB/OL]. 2026-08-24. https://modelscope.cn/learn/435959
[66] NInfer 专用引擎 4090 实测(MTP3 代码解码 148.6 tok/s、接受率 81%)[EB/OL]. 2026-08-15. https://github.com/sergiuszm/ninfer-4090
[67] Kingy AI:Qwen3.8-27B vs Qwen3.6-27B vs Gemma 4 31B 同卡(4090 24G Q4_K_M)对比(速度与 3.6 打平、质量领先;"24GB 单卡最佳默认选择")[EB/OL]. 2026-08-17. https://kingy.ai/blog/qwen3-8-27b-vs-qwen3-6-27b-vs-gemma-4-31b/
[68] 掘金:Qwen3.6-27B FP8 单卡 4090 48G 改装一手实测(类推;26.5→68.6 tok/s,262K+MTP 跑通)[EB/OL]. 2026-08-13. https://juejin.cn(4090 48G Qwen3.6-27B 实测)
[69] GitHub hogeheer499/strix-halo-guide:Strix Halo 实测库(Llama 3.1 70B Q4_K_M 4.7-4.9 tok/s,达理论带宽上限 94%)[EB/OL]. 2026-07-27. https://github.com/hogeheer499-commits/strix-halo-guide
[70] insidepc.tech:DGX Spark / Mac Studio / Strix Halo 三平台基准汇总(Llama 4 Scout 109B/17B 激活 Q4 在 Strix Halo 20.23 tok/s;70B 稠密 5.05 tok/s)[EB/OL]. 2026-08-19. https://insidepc.tech/hardware/for-ai/ai-benchmarks/dgx-spark-protiv-mac-studio-strix-halo
[71] Hugging Face unsloth/DeepSeek-V4-Flash-0731-GGUF 仓库 changelog(llama.cpp DSpark 实测提速 1.84-1.91×;体积/内存阶梯)[EB/OL]. 2026-08-06. https://huggingface.co/unsloth/DeepSeek-V4-Flash-0731-GGUF
[72] ZPedia(搜狐):V4-Flash 实测与架构解读(CSA 4× 压缩、Top-512 KV、HCA 128× 压缩,引 V4 技术报告)[EB/OL]. 2026-08-01. https://m.sohu.com/a/1057619104_122074763
[73] GitHub Reederey87:双 DGX Spark 部署 V4-Flash 生产实测(19.85GiB KV 容纳 3,027,217 token ≈ 6.9KB/token)[EB/OL]. 2026-08-23. https://github.com/Reederey87/dgx-spark-2x-deepseek-v4-flash
[74] 阿里云开发者社区:DeepSeek V3.2 MLA 1M KV ≈ 83.9GB 基线计算[EB/OL]. 2026-06-16. https://developer.aliyun.com/article/1741805
[75] llmrequirements.com:Apple M5 Max 本地 LLM 指南(V4-Flash 284B Q4 需约 192GB,激进 2-bit 约 110GB)[EB/OL]. 2026-07-08. https://llmrequirements.com/apple-m5-max-local-llm-guide
[76] Kingy AI:128GB Mac Studio 本地部署 V4-Flash-0731 深度整理(IQ2_M/Q2_K_XL 可装、64K 起步甜区、1M 无余量)[EB/OL]. 2026-08-02. https://kingy.ai/blog/deepseek-v4-flash-0731-128gb-mac-studio-local/
[77] 智源社区:ds4.c(antirez)V4-Flash 实测(M3 Max 128GB 生成 26.68 tok/s;M3 Ultra 512GB 生成 27.39 tok/s)[EB/OL]. 2026-05-09. https://hub.baai.ac.cn/view/54535
[78] rentamac.io:Mac 上运行 DeepSeek-V4 实测汇总(M3 Max ~27 / M5 Max ~34 / M3 Ultra 512GB ~37 tok/s)[EB/OL]. 2026(访问 2026-08). https://rentamac.io/run-deepseek-v4-mac/
[79] Framework 社区讨论:Strix Halo 多人报告 V4-Flash 20-30 tok/s @ 100K-500K 上下文[EB/OL]. 2026. https://community.frame.work/t/83736
[80] flowtivity.ai:双 DGX Spark TP2 实测(1M 上下文 41 tok/s;512K TTFT 334s;单台 131K 上下文降至 12-15 tok/s)[EB/OL]. 2026-06-10. https://flowtivity.ai
[81] noze.it:双 DGX Spark NVFP4+DSpark 短 prompt 82.4 tok/s 及口径拆解(单台短上下文 26.7 tok/s)[EB/OL]. 2026-08-06. https://noze.it
[82] arXiv 2608.16157(FreeToken,UC Berkeley/FlashML):RTX 5090 + 192GB DDR5 持续 decode 22-25 tok/s,较最强基线高 1.5-1.9×[EB/OL]. 2026-08-10. https://arxiv.org/html/2608.16157v1
[83] 85la.com:二手 Dell R940 + 双 RTX 3090 混合 offload 案例(单用户 ~33 tok/s、上下文 22K)[EB/OL]. 2026-08-03. https://www.85la.com/15625.html
[84] mypcrig:100B+ 模型 GPU/Mac 实测汇总(Qwen3-235B-A22B 在 M3 Ultra 512GB MLX 实测 24-30 tok/s,M5 Ultra 推算基数)[EB/OL]. 2026-05-25. https://mypcrig.com/blog/llm-100b-plus-gpu-benchmark-2026/
[85] oMLX 社区基准库:M3 Ultra 256GB 4-bit + Lightning MTP TG 32.6 tok/s@1K(8K 降至 24.5);M3 Ultra 512GB 8-bit 29.8 tok/s[EB/OL]. 2026-04 至 2026-08. https://omlx.ai/benchmarks/6po2mcnm
[86] GitHub kacper-daftcode/vLLM-Moet:1× RTX PRO 6000 96GB 161 tok/s、2× 210 tok/s、4× RTX 5090 214.4 tok/s[EB/OL]. 2026-07-10. https://github.com/kacper-daftcode/vLLM-Moet
[87] loftllc.dev(DwarfStar):RTX PRO 6000 Blackwell Max-Q 单卡 43.6 tok/s(Q2 压缩 + 自研 CUDA 后端)[EB/OL]. 2026-05-15. https://loftllc.dev/en/docs/tech/llm-research/dwarfstar4-rtx-pro-6000-deepseek-v4-flash-first-look/
[88] GitHub MiaAI-Lab:双 DGX Spark 官方权重 + NVFP4 KV(18GiB KV 池 = 249 万 token;1M 单流 55-82 tok/s,未做满长检索验证)[EB/OL]. 2026-08-14. https://github.com/MiaAI-Lab/DeepSeek-v4-Flash-DSpark-2x-DGX-Spark
[89] CSDN 大土咪:2× H100 80GB vLLM 官方路径部署 V4-Flash(decode 66.9 tok/s,1M 可启动,KV 池 149 万 token)[EB/OL]. 2026-07-01. https://deepseek.csdn.net/
[90] GitHub vllm-project/vllm issue #50576:8× A800 80GB 原型实测(单流 40.6 tok/s、1M 可启动、200K needle 通过)[EB/OL]. 2026-07-31. https://github.com/vllm-project/vllm/issues/50576
[91] MacRumors:2025 vs 2026 Mac Studio 指南(M3 Ultra 512GB/256GB 选项停产、96GB 涨至 $5,299)[EB/OL]. 2026-08-27. https://www.macrumors.com/guide/2025-vs-2026-mac-studio/
[92] 什么值得买:RTX 4090 全新库存 15,000+、二手倒挂至 19,000–21,000 元[EB/OL]. 2026-07-29. https://post.smzdm.com/p/awwx8pdp
[93] itcn.cc:RTX 5090 32G 京东自营到手 34,999–36,400 元[EB/OL]. 2026-07-30. https://www.itcn.cc/vga/2026073011294.html
[94] 快科技/MillionMiner:4090 48GB 涡轮满载 65 分贝@5000RPM、无官保、故障率约 2%[EB/OL]. 2025-03-27. https://news.mydrivers.com/blog/20250327.htm
[95] itcn.cc:RTX 4090D 48G 涡轮(扩容版)京东自营 19,999 元[EB/OL]. 2026-04-04. https://www.itcn.cc/vga/202604049354.html
[96] itcn.cc/淘宝/晨涧云:RTX 4090 48GB 涡轮京东秒杀 23,999 元、功耗墙锁 450W[EB/OL]. 2026-07-12. https://www.itcn.cc/vga/2026071211030.html
[97] 搜狐:2026-05 苹果下架 M4 Max 128GB、M3 Ultra 256GB 配置(内存供应危机)[EB/OL]. 2026-05-06. https://www.sohu.com/a/1018699530_122066678
[98] 优宝商城:Mac Studio M4 Max 128GB/4TB 第三方渠道 ¥35,670(无货、排产 8 周起)[EB/OL]. 2026. https://mall.yuobao.com/product/apple-mac-studiu-m4-max16-40-16-128g-4t
[99] 新浪/数智:Strix Halo 128GB 迷你机国行 ¥13,999–15,999(铭凡 MS-S1 MAX 等)[EB/OL]. 2025-10-19. https://www.sina.cn/news/detail/5223380286439874.html
[100] ZOL/iCEasy:DGX Spark 国内 ¥33,800–34,899、美国 $4,699(2026-02 上调)、实测约 100–181W[EB/OL]. 2026-08-22. https://detail.zol.com.cn/2147/2146064/price.shtml
[101] macbook-repair-dubai:Mac Studio M3 Ultra 192GB 美国 $5,499–6,999;持续功耗 M3 Ultra ~260W / M4 Max ~120W[EB/OL]. 2026-04-28. https://macbook-repair-dubai.ae/blog/mac-studio-m3-ultra-vs-m4-max-which
[102] 淘宝:4×RTX 4090 48GB(192GB)整机服务器报价 ¥150,499[EB/OL]. 2026-07-28. https://guangtao.taobao.com/product-8306c92e5c28c18fac205059f5ace78e63c7818c74e2e26a3105738e3b68593b.html
[103] dt-stor/快科技:二手 RTX 3090 国内 ¥3,000–4,500、eBay $600–800,多为过保高负载卡[EB/OL]. 2026-05-15. https://www.dt-stor.com/yingpanbaike/21928.html
[104] 超能网:RTX 5090 TDP 575W、非公实测满载 620W/峰值 717.6W[EB/OL]. 2025-01-25. https://www.expreview.com/97875.html
[105] AMD 官网:Ryzen AI Max+ Pro 395 默认 TDP 55W、cTDP 45–120W[EB/OL]. 2026-06-24. https://www.amd.com/zh-cn/products/processors/laptop/ryzen-pro/ai-max-pro-300-series/amd-ryzen-ai-max-plus-pro-395.html
[106] 百姓网/szhzzd:居民阶梯电价 0.5/0.55/0.8 元;深圳工商业分时 0.27–1.37 元[EB/OL]. 2026-06-10. https://www.szhzzd.cn/h-nd-5364.html
[107] projectwizards(Merlin Project TCO,引 Forrester):Mac 3 年残值企业口径 22–28%、个人二手市场 50–60%[EB/OL]. 2026-08-12. https://www.projectwizards.net/zh/blog/2026/08/mac-vs-pc-tco-calculator
[108] 百度 B2B 百科:高配显卡首年折价约 40%、三年后趋稳,大显存卡保值更高[EB/OL]. 2026-08-06. https://b2bwiki.baidu.com/article/758413846509846529
[109] 星宇智算 TCO 报告:8×H100 整机 25 万购入、3 年残值 7.5 万(30%)[EB/OL]. 2026-03-02. https://www.starverse-ai.com/guide/archives/2345
[110] 淘宝:UPS 1500VA/900W ¥200–680、在线式 2kVA ¥450–650[EB/OL]. 2026-07-28. https://guangtao.taobao.com/product-33d931bc2a6442641d00e90c285192e08502401b833e0fd2709effb966755d1d.html
[111] 阿里云官方定价页:qwen3.8-max 输入 ¥12/输出 ¥36(≈$2/$6)[EB/OL]. 2026-08-26. https://help.aliyun.com/zh/model-studio/model-pricing
[112] Spheron/Morph 对比文(引 Fireworks 官方文档):V4-Pro $1.74/$3.48、V4-Flash $0.14/$0.28[EB/OL]. 2026-07-17. https://spheron.network/blog/fireworks-ai-pricing-2026
[113] aipricing.guru:Together AI V4-Pro $2.10/$4.40、V4-Flash $0.14/$0.28[EB/OL]. 2026-08-29. https://aipricing.guru/together-pricing
[114] DoNews 转 SemiAnalysis:Claude Max $200 档月消耗等效 API 价值最高约 $8,000[EB/OL]. 2026-06-13. https://donews.com/news/detail/8/6594612.html
[115] tkcursor:Cursor Pro $20/月含 $20 额度、Ultra $200/月含 $400 额度[EB/OL]. 2026-08-07. https://tkcursor.com/cursor-pricing-guide-2026-cn
[116] techjacksolutions:GitHub Copilot Pro 39 / Max $100[EB/OL]. 2026-07-22. https://techjacksolutions.com/ai-tools/github-copilot/github-copilot-pricing
[117] nxcode:开发者 8 个月消耗 100 亿 token,API 等效 800[EB/OL]. 2026-04-06. https://nxcode.io/blog/claude-code-pricing-2026
[118] 雪球分析:2026 年行业集体涨价,智谱 Coding Plan 累计 +83%、DeepSeek 8 月调价[EB/OL]. 2026-08-18. https://xueqiu.com/2038506444/405494606
[119] Vibe Usage 实测博客(样本 98 人):OpenCode 用户月均 1.27 亿 token、Claude Code 1.6 亿,缓存命中率 67% vs 91%[EB/OL]. 2026-07-05. https://vibecafe.ai/usage/blog
[120] jdon.com 实测:RTX 5090 跑 Qwen3.8-27B 编码场景约 150 tok/s、满载 575W[EB/OL]. 2026-08-17. https://jdon.com/94043
[121] 快科技:DeepSeek V4.1 Flash 灰度测试(代码能力"天差地别",知识截止 2026-01)[EB/OL]. 2026-06-15. https://news.mydrivers.com/1/1129/1129663.htm
[122] The Information via IT之家:DeepSeek 向投资者承诺加快发布频率,V4.1 原定 6 月[EB/OL]. 2026-05-08. https://www.ithome.com/0/947/947.htm
[123] 百度百科:DeepSeek-R2 词条(1.2T MoE、SPCT 传闻与多次推迟史汇总)[EB/OL]. 2026-06-12. https://baike.baidu.com/item/DeepSeek-R2/65821204
[124] 虎嗅:DeepSeek 完成首轮外部融资约 500 亿元(梁文锋 200 亿、腾讯 100 亿)[EB/OL]. 2026-06-22. https://www.huxiu.com/article/4869328.html
[125] 百度百科:GLM-5.5 词条(摩根大通预测 2026 年 8 月发布、参数破 1T)[EB/OL]. 2026-08-25. https://baike.baidu.com/item/GLM-5.5/68081880
[126] The Information via 腾讯云开发者社区:MiniMax M3 Pro 研发中(2.7T,最早 2026 Q3 发布并开源)[EB/OL]. 2026-07-09. https://developer.cloud.tencent.com/news/4222485
[127] 南财社(新浪转载):Kimi K4"scale the *** up"庆功标语与赴港 IPO 前融资[EB/OL]. 2026-07-26. https://k.sina.com.cn/article_5953740931_162dee08306703qeos.html
[128] 钛媒体:Meta 发布闭源旗舰 Muse Spark、Llama API 关停("中段开放、前沿受控")[EB/OL]. 2026-07-05. https://www.tmtpost.com/agent/ai-article/18899
[129] SemiAnalysis via 雪球:RL 规模化是能力突破核心路径[EB/OL]. 2026-01-07. https://xueqiu.com/9993624771/369549455
[130] 百度百科:压缩稀疏注意力词条(NSA→DSA→CSA+HCA 演进与 Engram 条件记忆)[EB/OL]. 2026-04-28 更新. https://baike.baidu.com/item/压缩稀疏注意力/67696347
[131] iaipie:2026 年 8 月 17 日 AI 行业资讯速览(DeepSeek 组建 Harness 团队、V4-Pro 涨价与 Agent 化动向)[EB/OL]. 2026-08-17. https://iaipie.com/2026年8月17日ai行业资讯速览/
[132] Gurman via 快科技(新浪财经转载):苹果跳过 M6 Pro/Max,M7 标准版最早 2027 H1[EB/OL]. 2026-06-26. https://finance.sina.cn/stock/jdts/2026-06-26/detail-inieszsa2012998.d.html
[133] 快科技:SUPER 搁置主因 3GB GDDR7 颗粒成本(20)[EB/OL]. 2026-07-19. https://news.mydrivers.com/1/1137/1137508.htm
[134] kopite7kimi via Tom's Hardware:RTX 60 系采用 Rubin 架构、或 2027 H2 才发布[EB/OL]. 2026-01-07. https://tomshardware.com/pc-components/gpus/nvidias-next-gen-rtx-60-series-might-not-debut-until-the-second-half-of-2027
[135] 百度百科:Gorgon Halo(锐龙 AI Max 400,LPDDR5X-8533,约 273GB/s,2026Q4 上市)[EB/OL]. 2026-08-23. https://baike.baidu.com/item/Gorgon Halo
[136] 百度百科:Medusa Halo(Zen 6+RDNA 5+384-bit LPDDR6,理论带宽 455-614GB/s,预计 2027 发布)[EB/OL]. 2026-08-25. https://baike.baidu.com/item/Medusa Halo
[137] 观察者网:昇腾 950PR/Atlas 350 商用(FP4 1.56 PFLOPS、H20 的 2.87 倍、约 7 万元)及路线图[EB/OL]. 2026-03-21. https://guancha.cn/economy/2026_03_21_810876.shtml
[138] 快科技:SK 海力士 LPDDR6 完成验证、2026H2 量产(14.4Gbps,速度 +33%)[EB/OL]. 2026-08-01. https://news.mydrivers.com/1/1140/1140706.htm
[139] neoteric(Contra Collective):投机解码已成为主流推理运行时的默认特性(单流约 2×)[EB/OL]. 2026-05-16. https://neoteric.no/blog/speculative-decoding-why-local-ai-got-fast
[140] 游民星空:128GB RTX 5090 双面 PCB 改装卡现货(约 $13,200)[EB/OL]. 2025-09-08. https://www.gamersky.com/hardware/202509/2009924.shtml
[141] NVIDIA ModelOpt RFC:ModelOpt 成为 vLLM/SGLang 一等量化后端(NVFP4 路线图)[EB/OL]. 2026-06-12. https://github.com/NVIDIA/Model-Optimizer/issues/1699
[142] 快科技:宇瞻警告 2027 年通用 DRAM 供应量或骤降 70%[EB/OL]. 2026-07. https://news.mydrivers.com/1/1139/1139835.htm
[143] 新浪财经:TrendForce 预计 2027 年 HBM/DRAM 合约价继续大涨[EB/OL]. 2026-06-03. https://finance.sina.cn/stock/jdts/2026-06-03/detail-iniaavwv1024940.d.html
[144] NVIDIA 开发者论坛(entrpi):单 DGX Spark 128GB 以 2-bit 跑 V4-Flash 实测(权重 81-91GB、MMLU 79.5、单会话 1M)[EB/OL]. 2026-08-01. https://forums.developer.nvidia.com/t/378855
[145] 数码之家引中关村在线/涌现坐标渠道行情:RTX 5090 32G 国行全新非公成交价 27,500-31,000 元、二手 21,000-24,000 元[EB/OL]. 2026-08-12. https://www.mydigit.cn/thread-616038-1-1.html